

内推流程:
- 进入识别约吗二维码,输入约口令光宇内推活动,填写姓名手机号
- 发送邮件至zhongdaiqi@gyyx.cn
- 等待面试机会
内推流程:

要想把一个产品做,那不断的迭代完善是避免不了的。图书云1.1.3.3体验版刚出,体验期才1天,就正式上线了。经过打通公众号与小程序用户体系,目前图书云已经正式支持小程序与图书云公众号的信息互通、体系互通。当用户在小程序发起借阅,藏书人将能收到图书云公众号推送的实时消息,不会耽误用户之间借书。试想一下,如果没有通知,同事借本书,尴尬得不要不要的。
做为专注共享图书的图书云平台,已经进入1.1.3.4的迭代周期,每一位用户都可以反馈使用体验与改进建议,我们会依据迭代周期排期,为用户增加更多的实用功能,让图书共享更加便捷!【跳过两张图书云靓照,还有文字哦】


图书云做为共享图书平台,支持个人、企业、公司、事业单位、学校、俱乐部等各类有图书互换环节的场景,看书是一个永恒的话题,活到老学到老。做为一名技术人,也要不断的学习更新自己的技术储备,除了看电子书,纸质书有着自己独特的视觉感观。系统的学习一门知识,安静的看看书,这也许是图书云为每位用户勾勒出的一种原生态生活。
图书云共享图书,为每一位爱书爱学习的用户而努力!请关注我们图书云公众号,让我们聆听您的心声。我们将不断的更新迭代,让您拥有更加便利的图书共享工具,让13亿中国人彼此连接,形成全世界最大的图书馆-图书云!

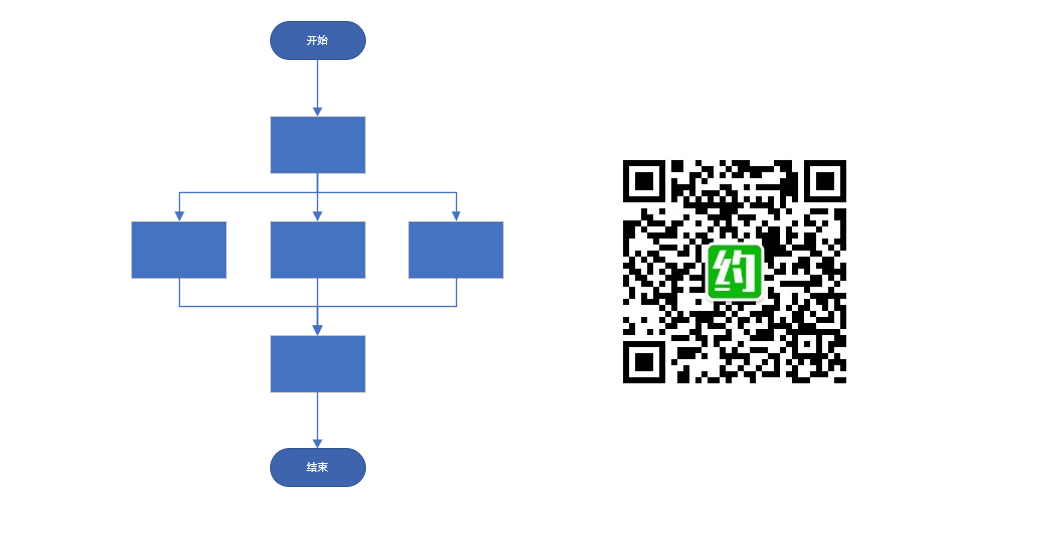
进入到经典大型互联网免费回制游戏《问道》,会看到很多游戏的主线故事,副本故事,故事大概是这样子:先去干什么,再去干什么,再去干什么。主线玩着玩着,还可以做副本故事。结合工作流、Storm Topology的经典,发起这些长得非常像,之间可以相互推导出来。
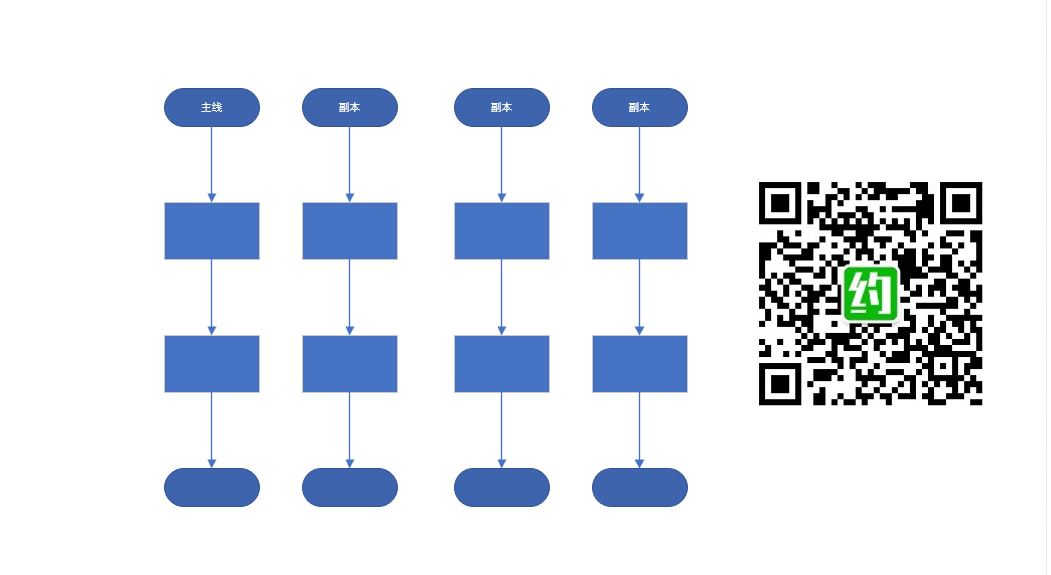
简化出来,游戏的故事情节可以这么表示:
今天的工作流&游戏主线副本故事&Storm Topology相互推导,看游戏圈与传统企业的千丝万缕情怀,先来看看工作流简化表示吧。
一个工作流的表示,就是今天的封面啦。从开始结节出发,经过一些节点处理,到达结束。
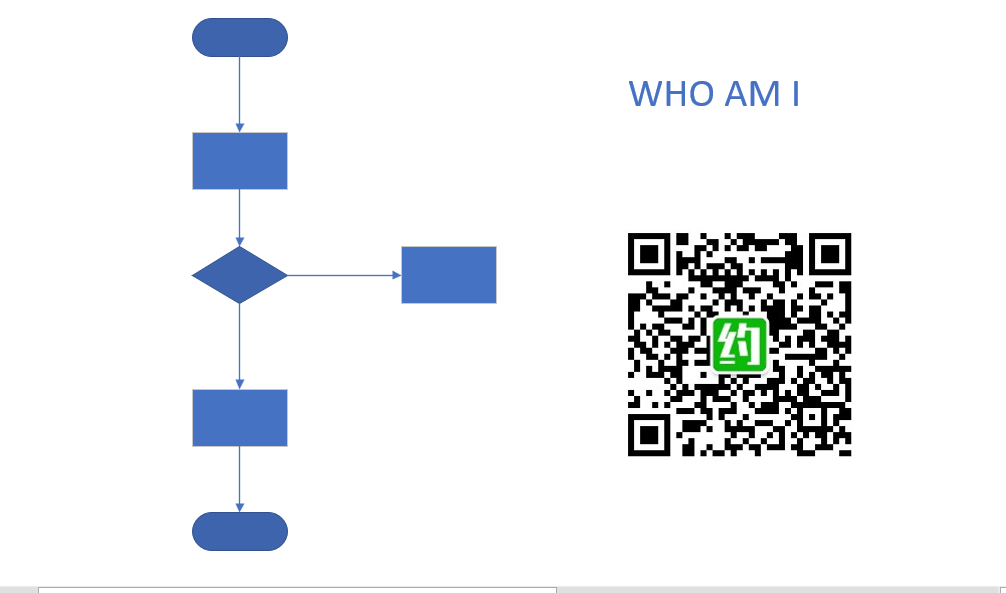
有没有感觉非常像游戏里面的故事主线,先干什么,再干什么?是的,至少我觉得是很像了。不现的主线,可以当成是不同的工作流,玩家进入不同的故事,相当于进入不同的工作流。相比之下,游戏的故事节点会比较长,节点处理更加单一,基本上是下一个节点,下一个节点,工作流中的节点处理则更加丰富。如果比较节点处理的可视化呈现,那自然是游戏更加直观了。
Storm Topolgy的处理,我经常喜欢画成横向的,基本上是长成这样子:
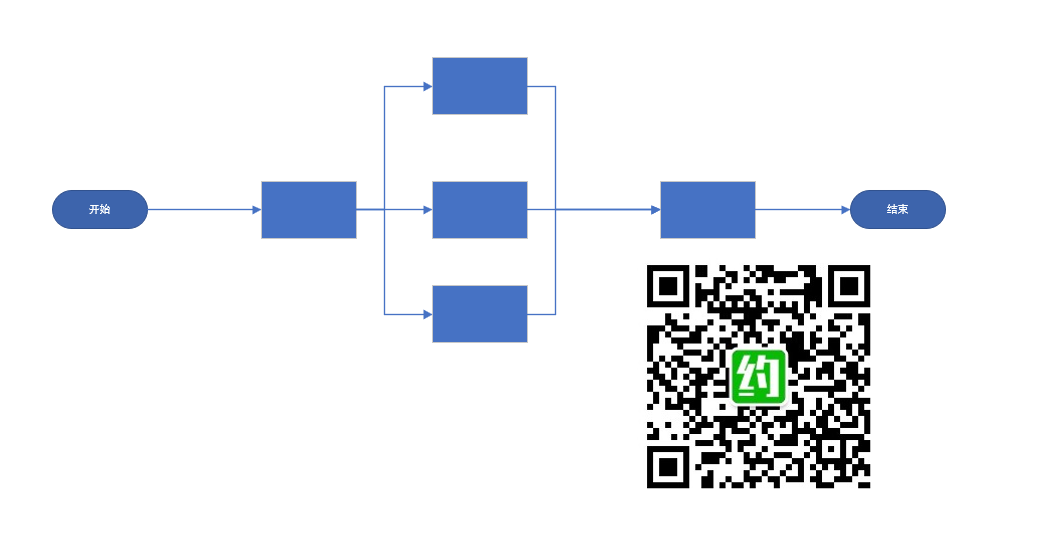
为了把三者归到一个体系中来,我画了一个竖版的,长得是这样子的:
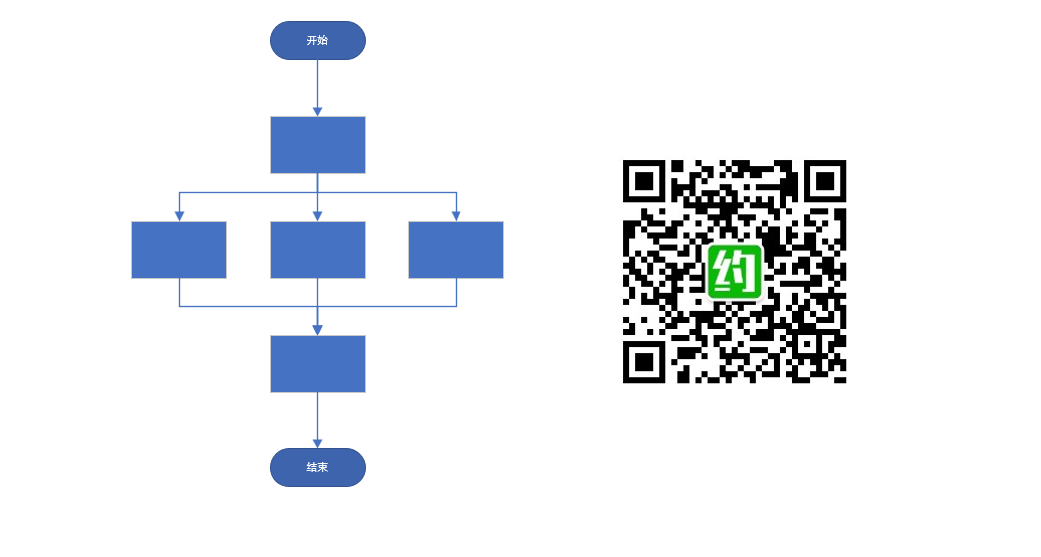
再比较工作流、游戏主线副本故事、Storm Topology,三者确实有着异曲同工的像。Storm Topology目前看到的实现形式是通过代码设置,如果做成配置模板,那这三者就统一成一类流程引擎中来了。
在传统企业中玩工作流,在大数据领域玩Storm Topology,都可以尝试实现一个游戏故事引擎。没有坐过飞机,还没有见过飞机飞。对于回合制游戏,有了故事引擎,感觉就有了一个核心啦!感觉兴趣的小伙伴,赶紧行动起来吧!


这篇文章适合在小公司成长的小伙伴,如果你恰好看到了,赶紧给自己的公司部署上这几个小工具,你会发现,省下了很多宝贵时间。将研发从代码开始就管理起来,嗯,就是这么神奇哦。
在小公司有这么个特点,一个人要干的活超级多,有些活非常繁琐,而且经常要干,占用了很多琐碎的时间,投入产出比低就不说了,主要是天天重复做,心如刀割,比如说代码管理,上线发布,代码质量检查等等。回想一下自己用的什么工具在管理代码、用的什么工具自动部署?今天要推荐的这个工具组合,能让代码管理、发布、部署做到质量管理、自动化。没有重复造轮子,有兴趣自己造轮子的,可以尝试一下。
No.1 Jenkins
在Jenkins中建立构建任务,把代码从GitLab上拉取下来,构建,Jenkins与sonarcube集成,进行代码质量检查,完成测试环境发布,将构件发布到自动部署的约定位置。
No.2 sonarqube
sonarqube is 我见过的最强大的代码质量检查工具了,能分析起各种坏味道,bug,不合理的代码编写,内置了很多检查规则,使用sonarqube可以让团队的代码编写统一规范,而且可以防止一些低级的写法出现。当然,配置sonarqube的检查规则的时候,最好也依据团队的编写做些小小的适应调整,比如写习惯了UserBLL会报上坏味道,要求写成UserBll,有结小小的不爽,是吧。统一规范就是舍去的过程,建立好了检查规范,大家都用sonarqube执行严格的代码检查,就好了。
No.3 gitlab
之前使用tfs,svn,后来被带入gitlab,使用gitlab,觉得使用git也不错哦。给自己的公司部署一个Gitlab,严格管理主干分支,新人在分支上玩,发起merge请求,合并主干,一下子管理就规范多了。
No.4 自动部署系统
可以自己DIY一个,也可以找个开源的,前几天有看到一个国内的小伙伴开源了一个自动部署系统,在这里就不推荐了。使用Jenkins构建完的war包,jar包,dll,可以使用自动部署系统管理起来,发布的时候,点一下,回滚的时候再点一下。
后记,自动部署系统可以对接上云主机、物理机、docker,嗯嗯~这么一套强大的系统,结合了Jenkins\sonarqube\gitlab,就是让小伙伴的时间能省下来。一定不要觉得前配置麻烦,这些工具配置好之后,后面就可以开心的玩耍了!
这么一套工具怎么配置,怎么才能搭建一套呢?回复公众号【研发工具】索取!
实在是找不到一个自己喜欢的英文单词来诠释这个小工具,BaibianJS(百变JS) is a little and amazing mini chrome extension!It will help you to inject js and send cross domain xhr request by setting Access-Control-Allow-Origin.百变JS是一个小巧实用的Chrome插件,主要2个功能,1是能帮您任性注入JS,2是通过让您任性跨域!
为什么会有BaibianJS
实战背景
要求爬取所有接口规格,找到带有特定参数的接口。
为了爬取接口进行分析,用到了hookAjax.js(有bug,有小影响),但是为了省事就将就用了。但是hook js需要注入js,同时结果需要存储到自己的数据库里,于是经过几天的探索,整理出一个BaibianJS。你可能看到的结果就一个小巧的Chrome插件,但是过程却很曲折。
我们原来的尝试过的方案(踩过的坑):
1.winform+webbrowser 通过js调winform,能跨域,js替换上出莫名其妙的问题。搬来fiddler进行请求模拟替换js,js注入进去了,但是还是有些bug问题,好像是hookAjax对ie的兼容问题。折腾了许久,此方案没有完全执行下去。因为有点厌倦了webbrower的调试,感觉不爽,也许自己的调试方式不对。
2.chrome+fiddler
用Fiddler替换掉js是没有问题,成功将jq.js替换成了hook.js(实际是hookAjax.js+jq.js),但是收集完成接口请求后,保持数据成了问题,提示跨域!采用动态生成script标签的形式跨域到是成功了,不过,传的数据过多,就报错了。URL毕竟是有长度限制。只是想用<iframe/>在内嵌一个页面,实现get转post,还未实战,不过,理论上是完全OK.
3.纯Chrome插件方案
Chrome插件是可以直接监控请求的,但是…嗯…不知道为什么有点晕晕的,没有用这个方案。因为对Chrome插件还是了解的一半一半的,时间有限,就不深挖了。
4.反向代理方案+
反向代理方案主要是通过反向代理服务器替换掉目前js,主要是jq.js,换成改造后的带hook的js,将一个存数据的请求反向配置到自己的站点。理论上也是完美的。虚拟机里的centos 7也安装了一个反向代理环境,不过,虚拟机吃内存,就…跳过了。
5.Chrome插件BaibianJs+hookAjax 【当前方案,已验】
用BaibianJS实现了反向代理的效果,直接配置替换掉原站的jq.js,换成注入后的js,同时BaibianJS关掉了跨域限制,直接将数据存到自己的站点
BaiBianJS充分利用了Chrome Extension的机制,几行代码就实现了。
=====看代码啦==============================
chrome.webRequest.onBeforeRequest.addListener( function(info) { //here to set your magic hook js //在这里设置你修改过的js,比如把自己的代码放到jq的最下面 return {redirectUrl:’http://localhost:6366/hook.min.js‘}; }, { // here to set which js be replaced //这里是设置哪个js要被替换掉,从jq下手,最好了 urls: [ "http://www.jishudao.com/js/jquery-1.7.1*" ], types: ["script"] }, ["blocking"]); //if you need to change more,add a new Listener
//set Access-Control-Allow-Origin chrome.webRequest.onHeadersReceived.addListener(function(details) { details.responseHeaders.push({name:’Access-Control-Allow-Origin’,value:"*"}); console.log(details.responseHeaders) return {responseHeaders:details.responseHeaders}; },{urls: ["<all_urls>"]}, ["responseHeaders","blocking"]);
=====看代码啦==============================
BaibianJS的定位
BaibianJS是给开发人员的一个小插件产品,使用上不是傻瓜式的,看不懂js的,可以绕行了。也没有提供管理界面,感觉这么简单的使用就好了。
下载BainbianJS插件文件,background.js\manifest.json,真正起作用的就这两个,放到一个BianbianJS文件夹里。进入Chrome Extension插件界面,选加载安装,选择BianbianJS文件夹,安装成功。
在谷歌浏览器中输入 chrome://extensions/
安装成功后,要依据自己的使用情况修改backgroud.js中的配置,配置要替换的JS,非常简单,就不废话了。修改JS记得重载加载插件哦!
直接Github下载代码 https://github.com/Lancker/BaibianJS

如果你觉得不错,想捐助献爱心,请扫码 
去哪儿网大数据中心在招人,主要是hadoop集群运维方向 有意者可以私聊地点:北京中关村待遇:30*16左右,关于去哪儿hadoop工作,请咨询(QQ群:300165122)群成员@白杨
Hadoop云计算QQ群:300165122,汇聚了业务近2000名从业人员,是国内较早一批投身Hadopp大数据工作的聚集地!本群主要进行业务技术交流,发布业内活动、工作机会!
Hadoop百度百科介绍: Hadoop是一个由Apache基金会所开发的分布式系统基础架构。 用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。 Hadoop实现了一个分布式文件系统(Hadoop Distributed File System),简称HDFS。HDFS有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件上;而且它提供高吞吐量(high throughput)来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。HDFS放宽了(relax)POSIX的要求,可以以流的形式访问(streaming access)文件系统中的数据。 Hadoop的框架最核心的设计就是:HDFS和MapReduce。HDFS为海量的数据提供了存储,则MapReduce为海量的数据提供了计算。
 转自: http://www.jishudao.com/2018/07/03/hadoop-bigdata-cloud-compute-job/