作者: zhongdaiqi

  • C#泛型编程

    泛型:通过参数化类型来实现在同一份代码上操作多种数据类型。利用“参数化类型”将类型抽象化,从而实现灵活的复用。

    例子代码:

    class Program

    {

    static void Main(string[] args)

    {

    int obj = 2;

    Test<int> test = new Test<int>(obj);

    Console.WriteLine(“int:” + test.obj);

    string obj2 = “hello world”;

    Test<string> test1 = new Test<string>(obj2);

    Console.WriteLine(“String:” + test1.obj);

    Console.Read();

    }

    }

    class Test<T>

    {

    public T obj;

    public Test(T obj)

    {

    this.obj = obj;

    }

    }

    输出结果是:

    int:2

    String:hello world

    程序分析:

    1、 Test是一个泛型类。T是要实例化的范型类型。如果T被实例化为int型,那么成员变量obj就是int型的,如果T被实例化为string型,那么obj就是string类型的。

    2、 根据不同的类型,上面的程序显示出不同的值。

    C#泛型机制:

    C#泛型能力有CLR在运行时支持:C#泛型代码在编译为IL代码和元数据时,采用特殊的占位符来表示范型类型,并用专有的IL指令支持泛型操作。而真正的泛型实例化工作以“on-demand”的方式,发生在JIT编译时。

    看看刚才的代码中Main函数的元数据

    .method private hidebysig static void Main(string[] args) cil managed

    {

    .entrypoint

    // Code size 79 (0x4f)

    .maxstack 2

    .locals init ([0] int32 obj,

    [1] class CSharpStudy1.Test`1<int32> test,

    [2] string obj2,

    [3] class CSharpStudy1.Test`1<string> test1)

    IL_0000: nop

    IL_0001: ldc.i4.2

    IL_0002: stloc.0

    IL_0003: ldloc.0

    IL_0004: newobj instance void class CSharpStudy1.Test`1<int32>::.ctor(!0)

    IL_0009: stloc.1

    IL_000a: ldstr “int:”

    IL_000f: ldloc.1

    IL_0010: ldfld !0 class CSharpStudy1.Test`1<int32>::obj

    IL_0015: box [mscorlib]System.Int32

    IL_001a: call string [mscorlib]System.String::Concat(object,

    object)

    IL_001f: call void [mscorlib]System.Console::WriteLine(string)

    IL_0024: nop

    IL_0025: ldstr “hello world”

    IL_002a: stloc.2

    IL_002b: ldloc.2

    IL_002c: newobj instance void class CSharpStudy1.Test`1<string>::.ctor(!0)

    IL_0031: stloc.3

    IL_0032: ldstr “String:”

    IL_0037: ldloc.3

    IL_0038: ldfld !0 class CSharpStudy1.Test`1<string>::obj

    IL_003d: call string [mscorlib]System.String::Concat(string,

    string)

    IL_0042: call void [mscorlib]System.Console::WriteLine(string)

    IL_0047: nop

    IL_0048: call int32 [mscorlib]System.Console::Read()

    IL_004d: pop

    IL_004e: ret

    } // end of method Program::Main

    再来看看Test类中构造函数的元数据

    .method public hidebysig specialname rtspecialname

    instance void .ctor(!T obj) cil managed

    {

    // Code size 17 (0x11)

    .maxstack 8

    IL_0000: ldarg.0

    IL_0001: call instance void [mscorlib]System.Object::.ctor()

    IL_0006: nop

    IL_0007: nop

    IL_0008: ldarg.0

    IL_0009: ldarg.1

    IL_000a: stfld !0 class ConsoleCSharpTest1.Test`1<!T>::obj

    IL_000f: nop

    IL_0010: ret

    } // end of method Test`1::.ctor

    1、第一轮编译时,编译器只为Test<T>类型产生“泛型版”的IL代码与元数据——并不进行泛型的实例化,T在中间只充当占位符。例如:Test类型元数据中显示的<!T>

    2、JIT编译时,当JIT编译器第一次遇到Test<int>时,将用int替换“范型版”IL代码与元数据中的T——进行泛型类型的实例化。例如:Main函数中显示的<int>

    3、CLR为所有类型参数为“引用类型”的泛型类型产生同一份代码;但是如果类型参数为“值类型”,对每一个不同的“值类型”,CLR将为其产生一份独立的代码。因为实例化一个引用类型的泛型,它在内存中分配的大小是一样的,但是当实例化一个值类型的时候,在内存中分配的大小是不一样的。

    C#泛型特点:

    1、如果实例化泛型类型的参数相同,那么JIT编辑器会重复使用该类型,因此C#的动态泛型能力避免了C++静态模板可能导致的代码膨胀的问题。

    2、C#泛型类型携带有丰富的元数据,因此C#的泛型类型可以应用于强大的反射技术。

    3、C#的泛型采用“基类、接口、构造器,值类型/引用类型”的约束方式来实现对类型参数的“显示约束”,提高了类型安全的同时,也丧失了C++模板基于“签名”的隐式约束所具有的高灵活性

    C#泛型继承:

    C#除了可以单独声明泛型类型(包括类与结构)外,也可以在基类中包含泛型类型的声明。但基类如果是泛型类,它的类型要么以实例化,要么来源于子类(同样是泛型类型)声明的类型参数,看如下类型

    class C<U,V>

    class D:C<string,int>

    class E<U,V>:C<U,V>

    class F<U,V>:C<string,int>

    class G:C<U,V> //非法

    E类型为C类型提供了U、V,也就是上面说的来源于子类

    F类型继承于C<string,int>,个人认为可以看成F继承一个非泛型的类

    G类型为非法的,因为G类型不是泛型,C是泛型,G无法给C提供泛型的实例化

    泛型类型的成员:

    泛型类型的成员可以使用泛型类型声明中的类型参数。但类型参数如果没有任何约束,则只能在该类型上使用从System.Object继承的公有成员。如下图:

    泛型接口:

    泛型接口的类型参数要么已实例化,要么来源于实现类声明的类型参数

    泛型委托:

    泛型委托支持在委托返回值和参数上应用参数类型,这些参数类型同样可以附带合法的约束

    delegate bool MyDelegate<T>(T value);

    class MyClass

    {

    static bool F(int i){…}

    static bool G(string s){…}

    static void Main()

    {

    MyDelegate<string> p2 = G;

    MyDelegate<int> p1 = new MyDelegate<int>(F);

    }

    }

    泛型方法:

    1、C#泛型机制只支持“在方法声明上包含类型参数”——即泛型方法。

    2、C#泛型机制不支持在除方法外的其他成员(包括属性、事件、索引器、构造器、析构器)的声明上包含类型参数,但这些成员本身可以包含在泛型类型中,并使用泛型类型的类型参数。

    3、泛型方法既可以包含在泛型类型中,也可以包含在非泛型类型中。

    泛型方法声明:如下

    public static int FunctionName<T>(T value){…}

    泛型方法的重载:

    public void Function1<T>(T a);

    public void Function1<U>(U a);

    这样是不能构成泛型方法的重载。因为编译器无法确定泛型类型T和U是否不同,也就无法确定这两个方法是否不同

    public void Function1<T>(int x);

    public void Function1(int x);

    这样可以构成重载

    public void Function1<T>(T t) where T:A;

    public void Function1<T>(T t) where T:B;

    这样不能构成泛型方法的重载。因为编译器无法确定约束条件中的A和B是否不同,也就无法确定这两个方法是否不同

    泛型方法重写:

    在重写的过程中,抽象类中的抽象方法的约束是被默认继承的。如下:

    abstract class Base

    {

    public abstract T F<T,U>(T t,U u) where U:T;

    public abstract T G<T>(T t) where T:IComparable;

    }

    class MyClass:Base

    {

    public override X F<X,Y>(X x,Y y){…}

    public override T G<T>(T t) where T:IComparable{}

    }

    对于MyClass中两个重写的方法来说

    F方法是合法的,约束被默认继承

    G方法是非法的,指定任何约束都是多余的

    泛型约束:

    1、C#泛型要求对“所有泛型类型或泛型方法的类型参数”的任何假定,都要基于“显式的约束”,以维护C#所要求的类型安全。

    2、“显式约束”由where子句表达,可以指定“基类约束”,“接口约束”,“构造器约束”,“值类型/引用类型约束”共四种约束。

    3、“显式约束”并非必须,如果没有指定“显式约束”,范型类型参数将只能访问System.Object类型中的公有方法。例如:在开始的例子中,定义的那个obj成员变量。比如我们在开始的那个例子中加入一个Test1类,在它当中定义两个公共方法Func1、Func2,如下图:

    下面就开始分析这些约束:

    基类约束:

    class A

    {

    public void Func1()

    { }

    }

    class B

    {

    public void Func2()

    { }

    }

    class C<S, T>

    where S : A

    where T : B

    {

    public C(S s,T t)

    {

    //S的变量可以调用Func1方法

    s.Func1();

    //T的变量可以调用Func2方法

    t.Func2();

    }

    }

    接口约束:

    interface IA<T>

    {

    T Func1();

    }

    interface IB

    {

    void Func2();

    }

    interface IC<T>

    {

    T Func3();

    }

    class MyClass<T, V>

    where T : IA<T>

    where V : IB, IC<V>

    {

    public MyClass(T t,V v)

    {

    //T的对象可以调用Func1

    t.Func1();

    //V的对象可以调用Func2和Func3

    v.Func2();

    v.Func3();

    }

    }

    构造器约束:

    class A

    {

    public A()

    { }

    }

    class B

    {

    public B(int i)

    { }

    }

    class C<T> where T : new()

    {

    T t;

    public C()

    {

    t = new T();

    }

    }

    class D

    {

    public void Func()

    {

    C<A> c = new C<A>();

    C<B> d = new C<B>();

    }

    }

    d对象在编译时报错:The type B must have a public parameterless constructor in order to use it as parameter ‘T’ in the generic type or method C<T>

    注意:C#现在只支持无参的构造器约束

    此时由于我们为B类型写入了一个有参构造器,使得系统不会再为B自动创建一个无参的构造器,但是如果我们将B类型中加一个无参构造器,那么对象d的实例化就不会报错了。B类型定义如下:

    class B

    {

    public B()

    { }

    public B(int i)

    { }

    }

    值类型/引用类型:

    public struct A { }

    public class B { }

    public class C<T> where T : struct

    {

    }

    C<A> c1 = new C<A>();

    C<B> c2 = new C<B>();

    c2对象在编译时报错:The type ‘B’ must be a non-nullable value type in order to use it as parameter ‘T’ in the generic type or methor ‘C<T>’

    总结:

    1、C#的泛型能力由CLR在运行时支持,它既不同于C++在编译时所支持的静态模板,也不同于Java在编译器层面使用“擦拭法”支持的简单的泛型。

    2、C#的泛型支持包括类、结构、接口、委托四种泛型类型,以及方法成员。

    3、C#的泛型采用“基类,接口,构造器,值类型/引用类型”的约束方式来实现对类型参数的“显式约束”,它不支持C++模板那样的基于签名的隐式约束。

    转自:http://www.cnblogs.com/kid-li/archive/2006/11/29/577045.html
  • “找你妹”在工作中的应用:Null值无法转化为数值

    Bug提示得非常迷惑,不好直接定位问题。
    第一步:定位到出错的代码段,查看报错信息。找不出具体问题,出现代码是将一个JSON串序列化成一个对象,字段较多,使用Chrome反序列化之后的结果一看,好多字段是null,到底是哪个字段引发的bug。如果Mock此段代码,逐一去检测,好像是一种处理方式。But…还得倒腾工程,于是暂时搁置此思路。
    第二步:整体上分析此段代码,这段代码的整体特征是,由代码生成工具生成。莫非被人工改动过?为了验证此猜想,立即生成了一遍,Compare的结果是,虽然人工调整过代码,但是与bug不相干,代码的调整仅限于页面显示文字的调整。
    第三步 “找你妹”,找了一个正常的具备类比性的模块代码配置,截个图,比着看了一下,结果发现,Client_id配置不一致。找开数据库查看字段类型,数据库不允许为空,实际业务上来,这个地方是为空的。
    第四步 调整Client_ID字段类型,允许为空,配置代码生成规则,允许Client_ID为空,K.O.
    第五步 以生产环境备份做基线测试…
    K.O.

  • Configure an Application Pool to Recycle at a Scheduled Time (IIS 7)

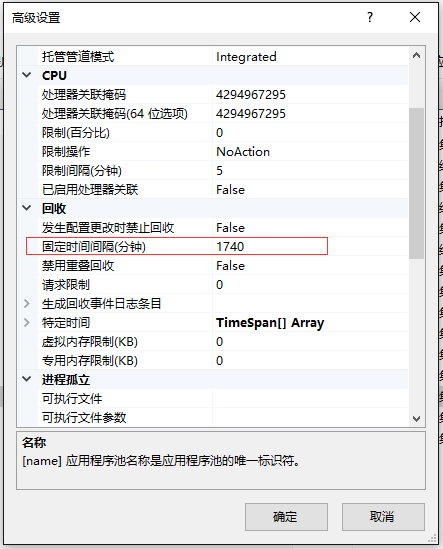
    IIS默认的应用程序池回收时间是29小时,这个时间,有点“神秘”,不排除在业务繁忙期间。因此指定在凌晨会更靠谱些。有的小伙伴写VB脚本,再计划任务,感觉不如直接使用appcmd命令直接解决指定时间回收的需求。

    image

    For example, to schedule an application pool named Marketing to recycle daily at 3:00 PM, type the following at the command prompt, and then press ENTER:

    appcmd set apppool /apppool.name: Marketing /+recycling.periodicRestart.schedule.[value=’15:00:00′]

    For example, if you want the Marketing application pool from the previous example to recycle at 5:00 PM, type the following at the command prompt and then press ENTER:

    appcmd set apppool /apppool.name: Marketing /recycling.periodicRestart.schedule.[value=’15:00:00′].value:17:00:00

    源自:https://technet.microsoft.com/en-us/library/6c74bc0a-cf98-4ac3-93c2-3991c09502fe

  • IIS站点不间断更新服务(热部署)IDEA

    最近做应用发布的工作比较多,考虑到白天会有第三方平台(跨境购)推送订单过来,一般白天也不做部署更新。如果白天要做部署,应该如何做呢?

    方案一:本身工程结构不做调整,增加一个第三方平台接口路由中转。

    由于第三方平台接口相对是稳定的,意味着接口路由器也是稳定的,接口路由器,有点像Channel Interface(Not every body known this),本身仅请第三方请求做中转,并将请求持久化下来。在做更新的时候,万一有订单、商品等请求过来,可以使用接口路由器重发报文。这样子,应用站点就可以任性的随时更新了,不用等到一个特定时间去部署更新。而且,怎么选时间去部署,都有丢报文的风险。

    方案二:调整工程,抽离引擎代码、业务代码,大DLL分解成小Dll,拆分,拆分

    这种做法与接口路由是有神似的地方,找出变化点,抽离出来。目前来看,工程build之后一个大大的api dll,内部系统、brother系统、第三方系统接口全在一起,内部做个小调整,部署还要影响第三方系统接口的正常访问。这个是一个问题点。另外,针对第三方平台的工程组成,至少分离出报文接收+报文处理,报文接收的调整可能性非常小,实时更新报文处理组件的时候,如造成异常,还能找到报文。

    调整自然有好有坏,这么拆拆拆,会拆出一堆小工程出来。一堆小组件,一堆小引擎。

    方案三:部署自动化,Package可以不断的发布到一个缓冲池里,凌晨的时候自动释放。

    这种方式,要求精心制作Package,能用自动验证Package是否正常发布,毕竟是自动完成。这种方式有点穿越,站在了不同的时间轴上。对于研发来说,发布,上传了Package,应用程序并不实时更新,但是可以当成“完成了”发布。这种方案同样需要研发一套Package标准+更新引擎。

    方案四:大名为“云部署”、“云应用”

    将Package部署包制作完之后,放到一个应用市场中,研发人员不管更新了,由业务人员依据业务情况更新。这种方案同样需要研发一套Package标准+更新引擎。这种方案,在软件客户超过1个,比较省心。如果达到几十上百,那应该是不错的部署更新方案了。

  • Select Update形成的死锁ABC

    事务(进程 ID 60)与另一个进程被死锁在 锁 资源上,并且已被选作死锁牺牲品。请重新运行该事务。

    查资料的大意,select使用了非聚集索引,会形成一个S锁,而update修改的列是非聚集索引的列,于是针对这个非聚集索引增加了一个X锁,然后就死锁了。

    我也被绕晕了,请自行查看原博主的文章详细了解。对于什么是聚集索引,什么是非聚集索引,偶也转载了一篇通俗易懂的文章 。就是上一篇啦!

    由于博主明确注意要经过允许后才转载,Balabala,来2个链接好了。

    参考解决方案 :

    http://blog.csdn.net/lishehe/article/details/42279147

    http://blog.csdn.net/lishehe/article/details/42303457

  • (转)聚合索引(clustered index) / 非聚合索引(nonclustered index)

    以下我面试经常问的2道题..尤其针对觉得自己SQL SERVER 还不错的同志.. 呵呵 很难有人答得好..
    各位在我收集每个人擅长的东西时,大部分都把SQL SERVER 标为Expert,看看是否答的上来..
    1. 什么是聚合索引(clustered index) / 什么是非聚合索引(nonclustered index)?
    2. 聚合索引和非聚合索引有什么区别?
    深入浅出理解索引结构     
    实际上,您可以把索引理解为一种特殊的目录。微软的SQL SERVER提供了两种索引:聚集索引(clustered index,也称聚类索引、簇集索引)和非聚集索引(nonclustered index,也称非聚类索引、非簇集索引)。下面,我们举例来说明一下聚集索引和非聚集索引的区别:     
    其实,我们的汉语字典的正文本身就是一个聚集索引。比如,我们要查”安”字,就会很自然地翻开字典的前几页,因为”安”的拼音是”an”,而按照拼音排序汉字的字典是以英文字母”a”开头并以”z”结尾的,那么”安”字就自然地排在字典的前部。如果您翻完了所有以”a”开头的部分仍然找不到这个字,那么就说明您的字典中没有这个字;同样的,如果查”张”字,那您也会将您的字典翻到最后部分,因为”张”的拼音是”zhang”。也就是说,字典的正文部分本身就是一个目录,您不需要再去查其他目录来找到您需要找的内容。     
    我们把这种正文内容本身就是一种按照一定规则排列的目录称为”聚集索引”。     
    如果您认识某个字,您可以快速地从自动中查到这个字。但您也可能会遇到您不认识的字,不知道它的发音,这时候,您就不能按照刚才的方法找到您要查的字,而需要去根据”偏旁部首”查到您要找的字,然后根据这个字后的页码直接翻到某页来找到您要找的字。但您结合”部首目录”和”检字表”而查到的字的排序并不是真正的正文的排序方法,比如您查”张”字,我们可以看到在查部首之后的检字表中”张”的页码是672页,检字表中”张”的上面是”驰”字,但页码却是63页,”张”的下面是”弩”字,页面是390页。很显然,这些字并不是真正的分别位于”张”字的上下方,现在您看到的连续的”驰、张、弩”三字实际上就是他们在非聚集索引中的排序,是字典正文中的字在非聚集索引中的映射。我们可以通过这种方式来找到您所需要的字,但它需要两个过程,先找到目录中的结果,然后再翻到您所需要的页码。     
    我们把这种目录纯粹是目录,正文纯粹是正文的排序方式称为”非聚集索引”。     
    通过以上例子,我们可以理解到什么是”聚集索引”和”非聚集索引”。     
    进一步引申一下,我们可以很容易的理解:每个表只能有一个聚集索引 ,因为目录只能按照一种方法进行排序。     
    (二)何时使用聚集索引或非聚集索引     
    下面的表总结了何时使用聚集索引或非聚集索引(很重要)。       
    动作描述                        使用聚集索引                       使用非聚集索引    
    列经常被分组排序              应                                       应    
    返回某范围内的数据          应                                       不应       
    一个或极少不同值           不应                                     不应    
    小数目的不同值                应                                       不应    
    大数目的不同值              不应                                      应    
    频繁更新的列                 不应                                      应    
    外键列                            应                                        应    
    主键列                            应                                        应    
    频繁修改索引列             不应                                       应    
    事实上,我们可以通过前面聚集索引和非聚集索引的定义的例子来理解上表。如:返回某范围内的数据一项。比如您的某个表有一个时间列,恰好您把聚合索引建立在了该列,这时您查询2004年1月1日至2004年10月1日之间的全部数据时,这个速度就将是很快的,因为您的这本字典正文是按日期进行排序的,聚类索引只需要找到要检索的所有数据中的开头和结尾数据即可;而不像非聚集索引,必须先查到目录中查到每一项数据对应的页码,然后再根据页码查到具体内容。     
    (三)结合实际,谈索引使用的误区     
    理论的目的是应用。虽然我们刚才列出了何时应使用聚集索引或非聚集索引,但在实践中以上规则却很容易被忽视或不能根据实际情况进行综合分析。下面我们将根据在实践中遇到的实际问题来谈一下索引使用的误区,以便于大家掌握索引建立的方法。     
    1、主键就是聚集索引     
    这种想法是极端错误的,是对聚集索引的一种浪费。虽然SQL SERVER默认是在主键上建立聚集索引的。     
    通常,我们会在每个表中都建立一个ID列,以区分每条数据,并且这个ID列是自动增大的,步长一般为1。我们的这个办公自动化的实例中的列Gid就是如此。此时,如果我们将这个列设为主键,SQL SERVER会将此列默认为聚集索引。这样做有好处,就是可以让您的数据在数据库中按照ID进行物理排序,但笔者认为这样做意义不大。     
    显而易见,聚集索引的优势是很明显的,而每个表中只能有一个聚集索引的规则,这使得聚集索引变得更加珍贵。     
    从我们前面谈到的聚集索引的定义我们可以看出,使用聚集索引的最大好处就是能够根据查询要求,迅速缩小查询范围,避免全表扫描。在实际应用中,因为ID号是自动生成的,我们并不知道每条记录的ID号,所以我们很难在实践中用ID号来进行查询。这就使让ID号这个主键作为聚集索引成为一种资源浪费。其次,让每个ID号都不同的字段作为聚集索引也不符合”大数目的不同值情况下不应建立聚合索引”规则;当然,这种情况只是针对用户经常修改记录内容,特别是索引项的时候会负作用,但对于查询速度并没有影响。     
    在办公自动化系统中,无论是系统首页显示的需要用户签收的文件、会议还是用户进行文件查询等任何情况下进行数据查询都离不开字段的是”日期”还有用户本身的”用户名”。     
    通常,办公自动化的首页会显示每个用户尚未签收的文件或会议。虽然我们的where语句可以仅仅限制当前用户尚未签收的情况,但如果您的系统已建立了很长时间,并且数据量很大,那么,每次每个用户打开首页的时候都进行一次全表扫描,这样做意义是不大的,绝大多数的用户1个月前的文件都已经浏览过了,这样做只能徒增数据库的开销而已。事实上,我们完全可以让用户打开系统首页时,数据库仅仅查询这个用户近3个月来未阅览的文件,通过”日期”这个字段来限制表扫描,提高查询速度。如果您的办公自动化系统已经建立的2年,那么您的首页显示速度理论上将是原来速度8倍,甚至更快。     
    在这里之所以提到”理论上”三字,是因为如果您的聚集索引还是盲目地建在ID这个主键上时,您的查询速度是没有这么高的,即使您在”日期”这个字段上建立的索引(非聚合索引)。下面我们就来看一下在1000万条数据量的情况下各种查询的速度表现(3个月内的数据为25万条):     
    (1)仅在主键上建立聚集索引,并且不划分时间段:     
    Select gid,fariqi,neibuyonghu,title from tgongwen  用时:128470毫秒(即:128秒)     
    (2)在主键上建立聚集索引,在fariq上建立非聚集索引:    
    select gid,fariqi,neibuyonghu,title from Tgongwen where  fariqi> dateadd(day,-90,getdate())   用时:53763毫秒(54秒)     
    (3)将聚合索引建立在日期列(fariqi)上:    
    select gid,fariqi,neibuyonghu,title from Tgongwen where  fariqi> dateadd(day,-90,getdate()) 用时:2423毫秒(2秒)     
    虽然每条语句提取出来的都是25万条数据,各种情况的差异却是巨大的,特别是将聚集索引建立在日期列时的差异。事实上,如果您的数据库真的有1000万容量的话,把主键建立在ID列上,就像以上的第1、2种情况,在网页上的表现就是超时,根本就无法显示。这也是我摒弃ID列作为聚集索引的一个最重要的因素。    
    得出以上速度的方法是:在各个select语句前加:declare @d datetime set @d=getdate()     
    并在select语句后加:    
    select [语句执行花费时间(毫秒)]=datediff(ms,@d,getdate())    
    2、只要建立索引就能显著提高查询速度     
    事实上,我们可以发现上面的例子中,第2、3条语句完全相同,且建立索引的字段也相同;不同的仅是前者在fariqi字段上建立的是非聚合索引,后者在此字段上建立的是聚合索引,但查询速度却有着天壤之别。所以,并非是在任何字段上简单地建立索引就能提高查询速度。     
    从建表的语句中,我们可以看到这个有着1000万数据的表中fariqi字段有5003个不同记录。在此字段上建立聚合索引是再合适不过了。在现实中,我们每天都会发几个文件,这几个文件的发文日期就相同,这完全符合建立聚集索引要求的:”既不能绝大多数都相同,又不能只有极少数相同”的规则。由此看来,我们建立”适当”的聚合索引对于我们提高查询速度是非常重要的。     
    3、把所有需要提高查询速度的字段都加进聚集索引,以提高查询速度     
    上面已经谈到:在进行数据查询时都离不开字段的是”日期”还有用户本身的”用户名”。既然这两个字段都是如此的重要,我们可以把他们合并起来,建立一个复合索引(compound index)。     
    很多人认为只要把任何字段加进聚集索引,就能提高查询速度,也有人感到迷惑:如果把复合的聚集索引字段分开查询,那么查询速度会减慢吗?带着这个问题,我们来看一下以下的查询速度(结果集都是25万条数据):(日期列fariqi首先排在复合聚集索引的起始列,用户名neibuyonghu排在后列)     
    (1)select gid,fariqi,neibuyonghu,title from Tgongwen where  fariqi>’2004-5-5′  查询速度:2513毫秒     
    (2)select gid,fariqi,neibuyonghu,title from Tgongwen where  fariqi>’2004-5-5′ and neibuyonghu=’办公室’   查询速度:2516毫秒     
    (3)select gid,fariqi,neibuyonghu,title from Tgongwen where  neibuyonghu=’办公室’   查询速度:60280毫秒     
    从以上试验中,我们可以看到如果仅用聚集索引的起始列作为查询条件和同时用到复合聚集索引的全部列的查询速度是几乎一样的,甚至比用上全部的复合索引列还要略快(在查询结果集数目一样的情况下);而如果仅用复合聚集索引的非起始列作为查询条件的话,这个索引是不起任何作用的。当然,语句1、2的查询速度一样是因为查询的条目数一样,如果复合索引的所有列都用上,而且查询结果少的话,这样就会形成”索引覆盖”,因而性能可以达到最优。同时,请记住:无论您是否经常使用聚合索引的其他列,但其前导列一定要是使用最频繁的列。     
    (四)其他书上没有的索引使用经验总结     
    1、用聚合索引比用不是聚合索引的主键速度快     
    下面是实例语句:(都是提取25万条数据)     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi=’2004-9-16′ 使用时间:3326毫秒     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where gid<=250000 使用时间:4470毫秒     
    这里,用聚合索引比用不是聚合索引的主键速度快了近1/4。     
    2、用聚合索引比用一般的主键作order by时速度快,特别是在小数据量情况下    
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  order by fariqi 用时:12936     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  order by gid  用时:18843    
    这里,用聚合索引比用一般的主键作order by时,速度快了3/10。事实上,如果数据量很小的话,用聚集索引作为排序列要比使用非聚集索引速度快得明显的多;而数据量如果很大的话,如10万以上,则二者的速度差别不明显。     
    3、使用聚合索引内的时间段,搜索时间会按数据占整个数据表的百分比成比例减少,而无论聚合索引使用了多少个     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi>’2004-1-1′ 用时:6343毫秒(提取100万条)    
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi>’2004-6-6′ 用时:3170毫秒(提取50万条)     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi=’2004-9-16′    
    用时:3326毫秒(和上句的结果一模一样。如果采集的数量一样,那么用大于号和等于号是一样的)     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi>’2004-1-1′ and fariqi<‘2004-6-6’ 用时:3280毫秒     
    4 、日期列不会因为有分秒的输入而减慢查询速度     
    下面的例子中,共有100万条数据,2004年1月1日以后的数据有50万条,但只有两个不同的日期,日期精确到日;之前有数据50万条,有5000个不同的日期,日期精确到秒。     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi>’2004-1-1′ order by fariqi 用时:6390毫秒     
    select gid,fariqi,neibuyonghu,reader,title from Tgongwen  where fariqi<‘2004-1-1’ order by fariqi 用时:6453毫秒    
    (五)其他注意事项     
    “水可载舟,亦可覆舟”,索引也一样。索引有助于提高检索性能,但过多或不当的索引也会导致系统低效。因为用户在表中每加进一个索引,数据库就要做更多的工作。过多的索引甚至会导致索引碎片。     
    所以说,我们要建立一个”适当”的索引体系,特别是对聚合索引的创建,更应精益求精,以使您的数据库能得到高性能的发挥。     
    当然,在实践中,作为一个尽职的数据库管理员,您还要多测试一些方案,找出哪种方案效率最高、最为有效。