京牌分析师 https://jp.zhongdaiqi.com/
202512期大屏数据:https://jp.zhongdaiqi.com/bigdata202512.html
如需原始数据,请关注公众号发送“索取数据”
京牌分析师 https://jp.zhongdaiqi.com/
202512期大屏数据:https://jp.zhongdaiqi.com/bigdata202512.html
如需原始数据,请关注公众号发送“索取数据”
京牌法拍官方网址 https://jpxkc.cbex.com/jpxkc/zc_prjs/2238.html
新北交互联APP https://otc.cbex.com/page/s/appdownload/pc
报名及保证金交纳截止时间:2025.12.12 15:00
竞价开始时间:2025.12.15 08:00
法拍交流京牌202506期统计分析与数据大屏
可查询不同摇号次数的预期法拍成功概率,也可以查看法拍大盘数据
法拍互动 https://yuema.zuime.com/
微群加Gindows
一图秒懂京牌法拍
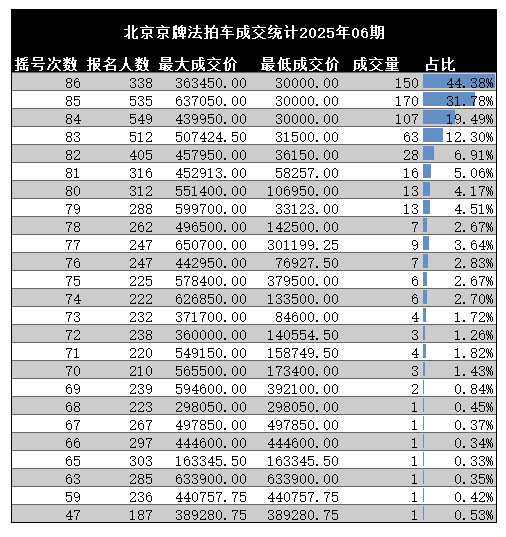
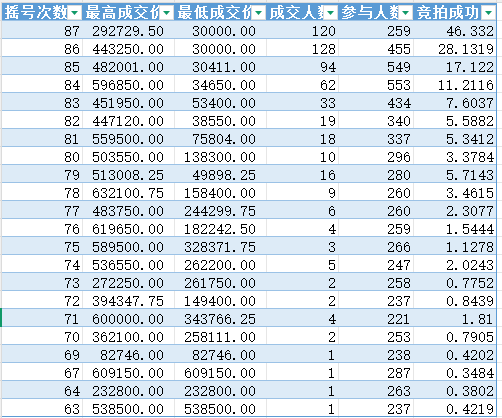
依据2025年06期的统计数据来看,摇号低于47次的属于陪跑,不推荐参与法拍。大满贯的朋友京牌法拍上岸率高达44%,建议摇号次数多的重点参与。参与北京小客气司法处置,3万拿京牌不是梦。不过,这个前提是摇号次数多,从历史数据来看,能3万拿到的摇号次数累计不低于85次。
华为鸿蒙激励计划政策查看
简单解读
上架一个应用分3次一共奖励1万元
上架一个月下载量50,奖励5000元【这个门槛非常低】
上架第二个月下载量100,奖励3000元
上架第三个月的月活200,奖励2000元
拿5000还是比较简单的,不懂鸿蒙编程也没有关系,巧用AI编程就好啦。下面讲讲如何利用AI快速完成鸿蒙应用开发与上线。
成功上线案例
图书云鸿蒙APP https://appgallery.huawei.com/app/detail?id=com.zuime.tsy.hm
通信商城鸿蒙APP https://appgallery.huawei.com/app/detail?id=com.zuime.txsc.hm
通信云鸿蒙APP https://appgallery.huawei.com/app/detail?id=com.zuime.txy
工具
CodeBudy AI编程工具
备案工作
一、联机应用需备案,需要使用到服务器
购买一个79一年的腾讯轻云服务器:https://curl.qcloud.com/byhsntD9
或者购买一个华为36元一年的云服务器:https://activity.huaweicloud.com/cps.html?fromacct=b6f8450e6b6149219eee8abf1f032821&utm_source=V1g3MDY4NTY=&utm_medium=cps&utm_campaign=201905
阿里云服务器38一年 https://www.aliyun.com/activity/1111/2025?userCode=dmbvv3xp
云服务器一般是一年优惠,一年会后比较贵
或者购买一个虚拟主机带数据库(60元一年,长期60元/年),可以私信找我购买虚拟主机(微信Gindows)
二、单机应用不需要备案,不需要购买服务器。
技术选型
前端方案
方案一 AI【CodeBudy AI】+DevEco-Studio
这个方案是通过AI工具写纯原生的鸿蒙应用。
方案二 AI【CodeBudy AI】+ 微信开发者工具 【推荐】
这个方案是通过微信多端打包能力,将js打包成鸿蒙APP,这个方案我觉得门槛更低,调试也更方便。会js就能搞鸿蒙APP。
后端方案
方案一 php+mysql 【推荐】
推荐虚拟主机,长期60一年,便宜,一年后应用可以继续保留。
方案二 python+mysql
方案三 java+mysql
需要云服务器,可自由部署环境,首年成本79,之后可能要500一年。
朋友们可依据自身的实际情况进行前后端的技术选型。
我推荐的技术选型
前端 AI【CodeBudy AI】+ 微信开发者工具 【推荐】
后端 php+mysql 【推荐】
部署工具 FileZilla https://pc.qq.com/detail/6/detail_22246.html
PHP框架选择:thinkphp https://www.thinkphp.cn/
实操
单机应用,可以跳过后端技术。但是个人推荐开发联网APP,这样子用户换手机不会丢失数据。
有问题可以加入我创建的鸿蒙开发者交流群,加tx_store加入微群。
# MultiQueryRetriever 原理与示例
## 1. 基本原理
MultiQueryRetriever 是 LangChain 框架中的一个高级检索器组件,它通过生成多个查询变体来提高检索效果。其核心思想是:**单一查询可能无法完全捕捉用户意图,而多个相关查询可以覆盖更广泛的语义空间**。
### 工作流程
1. **查询扩展**:使用大语言模型(LLM)将原始查询重写为多个不同表述的查询变体
2. **并行检索**:对每个查询变体分别执行向量检索
3. **结果合并**:将所有检索结果合并,去除重复内容
4. **返回文档**:返回最终的文档集合

### 优势
1. **提高召回率**:通过多种表述方式,增加找到相关文档的机会
2. **减少语义鸿沟**:弥补用户查询与文档表述之间的差异
3. **处理复杂查询**:将复杂查询分解为多个简单查询,更容易匹配到相关内容
4. **减少对精确关键词的依赖**:即使用户没有使用文档中的确切术语,也能找到相关内容
## 2. 实现细节
MultiQueryRetriever 在 LangChain 中的实现主要依赖于以下组件:
1. **基础检索器**:通常是向量存储的检索器,如 FAISS、Chroma 等
2. **语言模型**:用于生成查询变体,如 GPT、Claude、通义千问等
3. **查询生成提示模板**:指导语言模型如何生成有效的查询变体
### 核心代码实现
“`python
# 创建基础检索器
base_retriever = vectorstore.as_retriever(search_kwargs={“k”: 4})
# 创建MultiQueryRetriever
retriever = MultiQueryRetriever.from_llm(
retriever=base_retriever,
llm=llm
)
# 执行查询
docs = retriever.invoke(query)
“`
## 3. 实际示例
### 示例一:客户服务查询
**原始查询**:
“`
我的账户显示异常交易,怎么处理?
“`
**生成的查询变体**:
“`
1. 如何处理账户中的可疑交易?
2. 银行账户出现未授权交易的解决步骤
3. 发现账户异常交易记录后的处理流程
4. 账户交易异常,需要采取哪些安全措施?
“`
### 示例二:技术文档检索
**原始查询**:
“`
如何解决Docker容器无法连接网络的问题?
“`
**生成的查询变体**:
“`
1. Docker网络连接故障排查方法
2. 容器网络隔离导致的连接问题解决方案
3. Docker容器网络配置错误修复步骤
4. 如何检查和修复Docker网络桥接问题
“`
### 示例三:法律文档检索
**原始查询**:
“`
客户经理的考核标准是什么?
“`
**生成的查询变体**:
“`
1. 银行客户经理绩效评估指标有哪些?
2. 客户经理业绩考核的关键指标
3. 如何评价客户经理的工作表现和成效
4. 客户经理岗位的KPI设置和考核方法
“`
## 4. 代码实现示例
以下是一个完整的MultiQueryRetriever使用示例:
“`python
from langchain.retrievers.multi_query import MultiQueryRetriever
from langchain_community.vectorstores import FAISS
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.llms import Tongyi
import os
# 获取API密钥
DASHSCOPE_API_KEY = os.getenv(‘DASHSCOPE_API_KEY’)
if not DASHSCOPE_API_KEY:
raise ValueError(“请设置环境变量 DASHSCOPE_API_KEY”)
# 初始化语言模型
llm = Tongyi(model_name=”deepseek-v3″, dashscope_api_key=DASHSCOPE_API_KEY)
# 创建嵌入模型
embeddings = DashScopeEmbeddings(
model=”text-embedding-v1″,
dashscope_api_key=DASHSCOPE_API_KEY,
)
# 加载向量数据库
vectorstore = FAISS.load_local(“./vector_db”, embeddings, allow_dangerous_deserialization=True)
# 创建基础检索器
base_retriever = vectorstore.as_retriever(search_kwargs={“k”: 4})
# 创建MultiQueryRetriever
retriever = MultiQueryRetriever.from_llm(
retriever=base_retriever,
llm=llm
)
# 示例查询
query = “客户经理的考核标准是什么?”
# 查看生成的查询变体
generated_queries = retriever.generate_queries(query)
print(“原始查询:”, query)
print(“生成的查询变体:”)
for i, q in enumerate(generated_queries):
print(f”{i+1}. {q}”)
# 执行查询
results = retriever.invoke(query)
# 打印结果
print(f”\n找到 {len(results)} 个相关文档:”)
for i, doc in enumerate(results):
print(f”\n文档 {i+1}:”)
print(doc.page_content[:200] + “…” if len(doc.page_content) > 200 else doc.page_content)
“`
## 5. 与其他检索方法的比较
| 检索方法 | 优点 | 缺点 |
|———|——|——|
| **标准向量检索** | 实现简单,速度快 | 依赖单一查询表述,容易错过相关内容 |
| **MultiQueryRetriever** | 提高召回率,减少语义鸿沟 | 需要多次查询,增加API调用成本和延迟 |
| **HyDE检索** | 生成假设文档,提高相关性 | 依赖LLM生成高质量的假设文档 |
| **自查询检索** | 自动选择检索策略 | 实现复杂,需要更多计算资源 |
## 6. 最佳实践
1. **查询变体数量**:通常3-5个查询变体效果较好,过多可能引入噪音
2. **结果去重**:确保合并结果时有效去除重复内容
3. **LLM选择**:使用理解力强的LLM生成查询变体,如GPT-4、Claude、通义千问等
4. **向量检索参数调优**:根据应用场景调整k值和相似度阈值
5. **结合其他技术**:可与重排序、混合检索等技术结合使用
## 7. 应用场景
– **客户服务系统**:理解用户多样化的问题表述
– **法律文档检索**:处理复杂的法律查询
– **医疗信息系统**:匹配患者症状描述与医学文献
– **技术支持平台**:解决用户以不同方式描述的技术问题
– **教育资源检索**:帮助学生找到相关学习材料
MultiQueryRetriever是RAG系统中提高检索质量的重要工具,通过生成多样化的查询表述,有效弥补了用户查询与文档内容之间的语义差距。
打造企业本地知识库助手,结合了企业私有的知识库,又利用了大模型的生成能力。
整体流程:
1、使用 embeddings模型将企业知识文档向量化存入向量数据库Faiss中
2、接收用户问题,从本地知识库中查找相关性排名前N的知识块
3、让大模型依据本地知识回答用户问题
embeddings模型
embeddings文本向量化模型选择,为了减少下载与启动时长,快速跑起demo,我使用的是iic/nlp_gte_sentence-embedding_chinese-base模型,大概几百MB,下载比较快。可以对比通义千问系列其他模型,文件比较大,可能语文理解会更好。当量,也可以使用直接调用embeddings在线api,避免本地部署。
大模型大模型对机器的配置要求更高,可直接调用大模型服务,或者运行小尺寸的大模型。上代码代码我在本地调试运行过,可直接copy过去尝试一下。可稍微完善一下,就是一个企业本地知识库的智能助手。
import os
import sys
import time
import logging
import argparse
from typing import List, Tuple, Dict, Optional
from langchain_community.llms import Ollama
from langchain_openai import ChatOpenAI
# 配置日志
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)
# 检查必要的依赖库
try:
from PyPDF2 import PdfReader
from langchain.chains.question_answering import load_qa_chain
from langchain_openai import OpenAI
from langchain_community.callbacks.manager import get_openai_callback
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain_community.vectorstores import FAISS
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import torch
import torch.nn.functional as F
from langchain.embeddings.base import Embeddings
except ImportError as e:
print(f"错误: 缺少必要的依赖库: {str(e)}")
print("请安装所需依赖: pip install PyPDF2 langchain langchain-openai langchain-community faiss-cpu modelscope torch")
sys.exit(1)
# 自定义 ModelScope 嵌入类
class ModelScopeEmbeddings(Embeddings):
"""使用 ModelScope 加载的模型进行文本嵌入"""
# 类变量用于缓存已加载的模型
_models_cache = {}
def __init__(self, model_id: str = "iic/nlp_gte_sentence-embedding_chinese-base",
device: str = None, batch_size: int = 32, use_query_prefix: bool = True):
"""
初始化 ModelScope 嵌入模型
参数:
model_id: ModelScope 模型ID
device: 计算设备,如 'cuda:0', 'cpu' 等,默认为自动选择
batch_size: 批处理大小,用于处理大量文档
use_query_prefix: 是否为查询添加前缀
"""
self.model_id = model_id
self.batch_size = batch_size
self.use_query_prefix = use_query_prefix
# 设置设备
if device is None:
self.device = "cuda" if torch.cuda.is_available() else "cpu"
else:
self.device = device
# 缓存键
cache_key = f"{model_id}_{self.device}"
try:
# 检查模型是否已经加载
if cache_key in self._models_cache:
logger.info(f"使用缓存中的模型: {model_id}")
self.tokenizer, self.model = self._models_cache[cache_key]
else:
# 检查模型是否已经下载
try:
# 尝试直接加载本地模型
self.model_dir = snapshot_download(model_id, cache_dir=os.path.join(os.path.expanduser("~"), ".cache", "modelscope"))
logger.info(f"模型已存在于本地缓存: {self.model_dir}")
except Exception as e:
logger.info(f"本地未找到模型,正在从 ModelScope 下载模型 {model_id}...")
try:
self.model_dir = snapshot_download(model_id)
logger.info(f"模型已下载到: {self.model_dir}")
except Exception as download_error:
logger.error(f"下载模型时出错: {str(download_error)}")
raise ValueError(f"无法下载模型 {model_id}: {str(download_error)}")
# 加载模型和分词器
logger.info(f"正在加载模型到 {self.device} 设备...")
try:
self.tokenizer = AutoTokenizer.from_pretrained(self.model_dir)
self.model = AutoModel.from_pretrained(self.model_dir)
self.model.to(self.device)
# 缓存模型
self._models_cache[cache_key] = (self.tokenizer, self.model)
logger.info(f"模型已加载并缓存")
except Exception as load_error:
logger.error(f"加载模型时出错: {str(load_error)}")
raise ValueError(f"无法加载模型: {str(load_error)}")
except Exception as e:
logger.error(f"初始化 ModelScope 嵌入模型时出错: {str(e)}")
raise ValueError(f"初始化失败: {str(e)}")
def _mean_pooling(self, model_output, attention_mask):
"""平均池化获取句子嵌入"""
token_embeddings = model_output[0]
input_mask_expanded = attention_mask.unsqueeze(-1).expand(token_embeddings.size()).float()
return torch.sum(token_embeddings * input_mask_expanded, 1) / torch.clamp(input_mask_expanded.sum(1), min=1e-9)
def embed_documents(self, texts: List[str]) -> List[List[float]]:
"""
为文档生成嵌入向量
参数:
texts: 文档文本列表
返回:
embeddings: 嵌入向量列表
"""
if not texts:
return []
try:
# 分批处理文档
all_embeddings = []
for i in range(0, len(texts), self.batch_size):
batch_texts = texts[i:i+self.batch_size]
# 对文本进行编码
encoded_input = self.tokenizer(
batch_texts,
padding=True,
truncation=True,
max_length=512, # 添加最大长度限制
return_tensors='pt'
).to(self.device)
# 生成嵌入
with torch.no_grad():
model_output = self.model(**encoded_input)
# 池化并归一化
sentence_embeddings = self._mean_pooling(model_output, encoded_input['attention_mask'])
normalized_embeddings = F.normalize(sentence_embeddings, p=2, dim=1)
# 添加到结果列表
all_embeddings.extend(normalized_embeddings.cpu().tolist())
return all_embeddings
except Exception as e:
logger.error(f"生成文档嵌入时出错: {str(e)}")
# 在出错时返回零向量,避免程序崩溃
if len(texts) > 0:
try:
# 尝试获取嵌入维度
dummy_output = self.embed_documents([texts[0]])
dim = len(dummy_output[0])
return [[0.0] * dim] * len(texts)
except:
# 如果无法确定维度,使用默认维度
return [[0.0] * 768] * len(texts)
return []
def embed_query(self, text: str) -> List[float]:
"""
为查询生成嵌入向量
参数:
text: 查询文本
返回:
embedding: 嵌入向量
"""
if not text:
# 返回零向量
return [0.0] * 768
try:
# 为查询添加提示词(如果启用)
query_text = f"查询:{text}" if self.use_query_prefix else text
return self.embed_documents([query_text])[0]
except Exception as e:
logger.error(f"生成查询嵌入时出错: {str(e)}")
# 返回零向量
return [0.0] * 768
class PDFChatBot:
"""PDF聊天机器人类,用于处理PDF文档并回答相关问题"""
def __init__(self, pdf_path: str, api_key: str, base_url: str = "https://dashscope.aliyuncs.com/compatible-mode/v1",
model_id: str = "iic/nlp_gte_sentence-embedding_chinese-base",
device: str = None, use_query_prefix: bool = True,
llm_model_name: str = "deepseek-r1:1.5b"):
"""
初始化PDF聊天机器人
参数:
pdf_path: PDF文件路径
api_key: OpenAI API密钥
base_url: API基础URL
model_id: ModelScope模型ID,用于文本嵌入
device: 计算设备,如 'cuda:0', 'cpu' 等,默认为自动选择
use_query_prefix: 是否为查询添加前缀
"""
self.pdf_path = pdf_path
self.api_key = api_key
self.base_url = base_url
self.model_id = model_id
self.device = device
self.use_query_prefix = use_query_prefix
self.llm_model_name = llm_model_name
self.knowledge_base = None
self.page_count = 0
# 检查PDF文件是否存在
if not os.path.exists(pdf_path):
raise FileNotFoundError(f"PDF文件不存在: {pdf_path}")
logger.info(f"初始化PDF聊天机器人,使用文件: {pdf_path}")
def load_pdf(self) -> None:
"""加载PDF文件并创建知识库"""
start_time = time.time()
logger.info(f"开始加载PDF文件: {self.pdf_path}")
try:
# 读取PDF文件
pdf_reader = PdfReader(self.pdf_path)
self.page_count = len(pdf_reader.pages)
logger.info(f"PDF文件共有 {self.page_count} 页")
# 提取文本和页码信息
text, page_numbers = self._extract_text_with_page_numbers(pdf_reader)
logger.info(f"提取的文本长度: {len(text)} 个字符")
if not text:
raise ValueError("无法从PDF中提取文本,请检查PDF文件是否有效")
# 处理文本并创建知识库
self.knowledge_base = self._process_text_with_splitter(text, page_numbers)
elapsed_time = time.time() - start_time
logger.info(f"PDF加载和知识库创建完成,耗时: {elapsed_time:.2f} 秒")
except Exception as e:
logger.error(f"加载PDF文件时出错: {str(e)}")
raise
def _extract_text_with_page_numbers(self, pdf) -> Tuple[str, List[int]]:
"""
从PDF中提取文本并记录每页文本对应的页码
参数:
pdf: PDF文件对象
返回:
text: 提取的文本内容
page_numbers: 每页文本对应的页码列表
"""
text = ""
page_texts = [] # 存储每页的文本
page_numbers = [] # 存储每页的页码
for page_number, page in enumerate(pdf.pages, start=1):
try:
extracted_text = page.extract_text()
if extracted_text:
text += extracted_text + "\n\n" # 添加页面分隔符
page_texts.append(extracted_text)
page_numbers.append(page_number)
else:
logger.warning(f"第 {page_number} 页未找到文本")
except Exception as e:
logger.error(f"提取第 {page_number} 页文本时出错: {str(e)}")
return text, page_numbers
def _process_text_with_splitter(self, text: str, page_numbers: List[int]) -> FAISS:
"""
处理文本并创建向量存储
参数:
text: 提取的文本内容
page_numbers: 每页文本对应的页码列表
返回:
knowledgeBase: 基于FAISS的向量存储对象
"""
try:
# 创建文本分割器,用于将长文本分割成小块
text_splitter = RecursiveCharacterTextSplitter(
separators=["\n\n", "\n", ".", " ", ""],
chunk_size=1000,
chunk_overlap=200,
length_function=len,
)
# 分割文本
chunks = text_splitter.split_text(text)
logger.info(f"文本被分割成 {len(chunks)} 个块")
try:
# 创建嵌入模型 - 使用ModelScope的中文嵌入模型
logger.info(f"正在初始化 ModelScope 嵌入模型: {self.model_id}...")
embeddings = ModelScopeEmbeddings(
model_id=self.model_id,
device=self.device,
use_query_prefix=self.use_query_prefix
)
# 从文本块创建知识库
knowledge_base = FAISS.from_texts(chunks, embeddings)
logger.info("已从文本块创建知识库")
# 为每个文本块分配页码
knowledge_base.page_info = self._assign_page_numbers_to_chunks(text, chunks, page_numbers)
return knowledge_base
except Exception as e:
logger.error(f"创建嵌入模型或知识库时出错: {str(e)}")
raise ValueError(f"创建嵌入模型或知识库失败: {str(e)}. 请确保已安装sentence-transformers和faiss-cpu库")
except Exception as e:
logger.error(f"处理文本时出错: {str(e)}")
raise
def _assign_page_numbers_to_chunks(self, text: str, chunks: List[str], page_numbers: List[int]) -> Dict[str, int]:
"""
为每个文本块分配页码
参数:
text: 完整文本
chunks: 分割后的文本块
page_numbers: 页码列表
返回:
page_info: 文本块到页码的映射字典
"""
page_info = {}
try:
# 如果没有页码信息,则返回空字典
if not page_numbers:
logger.warning("没有页码信息,无法分配页码")
return page_info
# 简化页码分配算法,使用文本位置比例来估计页码
text_length = len(text)
for chunk in chunks:
chunk_position = text.find(chunk)
if chunk_position == -1:
# 如果找不到,使用最后一页
page_info[chunk] = page_numbers[-1]
else:
# 根据文本位置比例估计页码
position_ratio = chunk_position / text_length
page_index = min(int(position_ratio * len(page_numbers)), len(page_numbers) - 1)
page_info[chunk] = page_numbers[page_index]
return page_info
except Exception as e:
logger.error(f"分配页码时出错: {str(e)}")
# 出错时返回空字典,但不中断程序
return {}
def answer_question(self, query: str, top_k: int = 4) -> Dict:
"""
回答关于PDF内容的问题
参数:
query: 问题
top_k: 检索的相关文档数量
返回:
result: 包含回答和来源页码的字典
"""
if not self.knowledge_base:
raise ValueError("知识库尚未初始化,请先调用load_pdf()")
logger.info(f"处理问题: {query}")
try:
# 执行相似度搜索,找到与查询相关的文档
docs = self.knowledge_base.similarity_search(query, k=top_k)
llm = ChatOpenAI(
openai_api_key= "sk-xxxxxx", # 从环境变量获取 API Key
openai_api_base="https://dashscope.aliyuncs.com/compatible-mode/v1", # 百炼兼容端点
model_name="qwen-plus", # 指定阿里模型
temperature=0.2 # 控制生成随机性
)
# llm = Ollama(
# model="deepseek-r1:1.5b", # 直接指定模型名称
# base_url="http://localhost:11434", # Ollama 服务地址
# temperature=0.2 # 控制随机性
# )
# 加载问答链
chain = load_qa_chain(llm, chain_type="stuff")
# 准备输入数据
input_data = {"input_documents": docs, "question": query}
# 使用回调函数跟踪API调用成本
with get_openai_callback() as cost:
# 执行问答链
response = chain.invoke(input=input_data)
logger.info(f"查询已处理。成本: {cost}")
# 记录唯一的页码
unique_pages = set()
page_sources = []
# 显示每个文档块的来源页码
for i, doc in enumerate(docs):
text_content = getattr(doc, "page_content", "")
# 尝试直接匹配
source_page = self.knowledge_base.page_info.get(text_content, None)
# 如果直接匹配失败,尝试去除空白后匹配
if source_page is None:
for chunk, page in self.knowledge_base.page_info.items():
if chunk.strip() == text_content.strip():
source_page = page
break
# 如果仍然找不到匹配,使用默认值
if source_page is None:
source_page = "未知"
if source_page not in unique_pages:
unique_pages.add(source_page)
page_sources.append(source_page)
# 按页码排序
try:
page_sources = sorted([p for p in page_sources if isinstance(p, int)])
except Exception:
# 如果排序失败,使用原始列表
pass
return {
"answer": response["output_text"],
"sources": page_sources,
"cost": str(cost)
}
except Exception as e:
logger.error(f"回答问题时出错: {str(e)}")
raise
def main():
"""主函数,处理命令行参数并运行PDF聊天机器人"""
parser = argparse.ArgumentParser(description="PDF聊天机器人 - 使用FAISS向量数据库回答PDF文档相关问题")
parser.add_argument("--pdf", type=str, default="./xxx.pdf", help="PDF文件路径")
parser.add_argument("--api_key", type=str, default="sk-xxxxxx", help="OpenAI API密钥")
parser.add_argument("--base_url", type=str, default="http://localhost:11434/v1", help="API基础URL")
parser.add_argument("--model_id", type=str, default="iic/nlp_gte_sentence-embedding_chinese-base", help="ModelScope模型ID")
parser.add_argument("--device", type=str, help="计算设备,如 'cuda:0', 'cpu' 等")
parser.add_argument("--no_query_prefix", action="store_true", help="不为查询添加前缀")
parser.add_argument("--llm_model", type=str, default="deepseek-r1:1.5b", help="LLM模型名称")
args = parser.parse_args()
try:
# 检查PDF文件是否存在
if not os.path.exists(args.pdf):
print(f"错误: PDF文件不存在: {args.pdf}")
print("请提供有效的PDF文件路径")
sys.exit(1)
# 创建PDF聊天机器人
chatbot = PDFChatBot(
args.pdf,
args.api_key,
args.base_url,
args.model_id,
args.device,
not args.no_query_prefix,
args.llm_model
)
# 加载PDF文件
print(f"正在加载PDF文件: {args.pdf}...")
try:
chatbot.load_pdf()
except Exception as e:
print(f"加载PDF文件时出错: {str(e)}")
print("请确保PDF文件格式正确且可读取")
sys.exit(1)
print(f"\n成功加载PDF文件: {args.pdf}")
print(f"PDF共有 {chatbot.page_count} 页")
print("\n现在您可以开始提问了! 输入'退出'或'exit'结束对话。\n")
# 交互式问答循环
while True:
try:
query = input("\n请输入您的问题: ")
if query.lower() in ["退出", "exit", "quit", "q"]:
print("感谢使用PDF聊天机器人,再见!")
break
if not query.strip():
continue
try:
print("正在思考中...")
# 获取回答
result = chatbot.answer_question(query)
# 打印回答
print("\n回答:")
print(result["answer"])
# 打印来源
if result["sources"]:
print("\n来源页码:", ", ".join(map(str, result["sources"])))
# 打印成本
print(f"\n查询成本: {result['cost']}")
except Exception as e:
print(f"处理问题时出错: {str(e)}")
print("请尝试重新提问或检查API密钥是否有效")
except KeyboardInterrupt:
print("\n程序被用户中断。感谢使用PDF聊天机器人,再见!")
break
except Exception as e:
print(f"发生错误: {str(e)}")
except Exception as e:
print(f"程序运行出错: {str(e)}")
if __name__ == "__main__":
try:
main()
except Exception as e:
print(f"程序启动失败: {str(e)}")
print("请检查环境配置和依赖库安装情况")
0代码写二手车价格预测,下面不涉及写代码,遇到不懂的地方直接问AI,让AI解释就可以!
AI写代码主要给AI下达指令,让AI自动生成代码,运行代码,出错再让AI修复,直到目标达成。AI能快速把想法转化为代码实现。下面分享如何将MAE优化到499。
MAE越小说明,整体预测价格与真实价格偏差小,模型训练得越好。
进入阿里云搜索天池二车手价格预测
话不多说,开始AI编程
提示语
train.cvs是训练集、test.cvs是测试集,请生成二手车预测程序,要求使用CatBoost训练模型,预测结果写入cvs,并输出训练集MAE、验证集MAE
就这么给AI说句话,AI基本上就把一个二手车价格的预测程序写出来了!如果AI没有尝试读取cvs的列名,可以让AI写代码打印cvs列名并翻译字段的含义。天池有cvs的数据字典,也可以直接贴给AI。
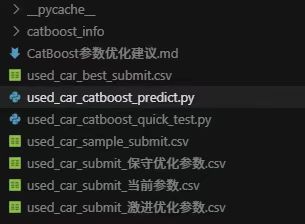
不做任何优化的话,验证集的MAE可能会很大,所以不能直接甩锅给AI。
二手车价格预测主要两个活,第一个是特征工程,第二步,模型参数优化。
特征工程做好了,MAE基本上能拿比较好的分。
提示语
对tain.cvs做EDA,将结果写入.md
提示语
对train.cvs做统计分析并给出特征工程建议写入 md,描述每一列的数据特征,是否有缺失值,给出缺失值的处理建议,是否有异常值,给出处理建议
提示语
依据分析结果落实建议
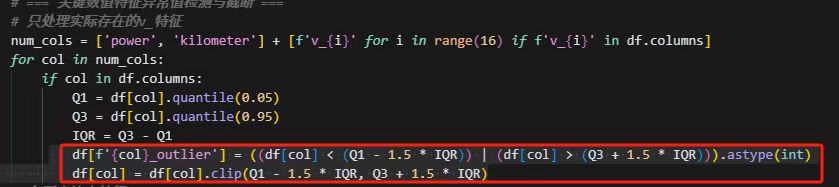
极端值处理
用这个代码替换了AI的
统计特征
给我感觉,如果不明确要求做统计特征操作,AI只做了异常值处理、空值填充等常规性操作!缺少统计特征。
提示语
tain.cvs划分成了训练集、验证集,test.cvs测试集。用训练集,统计不同品牌的价格特征形成衍生列,再合并到验证集、测试集。注意,不能直接使用验证集、测试集做统计,避免价格数据泄露
统计特征不做的话,MAE大概在560上下,做了统计特征,MAE能到517分上下。
统计特征包括均价、最小价格、最大价格、方差、标准差,可以是多种特征组合,比如:
不同品牌的价格统计特征,是不是很有实际意义,有的品牌溢价高,有的低。
不同品牌不同车龄的价格统计特征,体现出不同品牌的保值情况。
不同品牌不同车型的价格统计特征,也好理解吧
这里很容易出错的是,这种统计特征必须是在训练集统计,应用到验证集、测试集。如果直接用验证集的进行统计,会导致价格数据泄露,相当于让模型提前捕获到了验证集的价格信息。在数据上最大的体现就是MAE趋近于0,数值特别小,比如目前竞赛排行榜最好的成绩是300多分,因为这个误操作,本地可能跑出来MAE才8,提交到竞赛评估结果可能是2000,存在巨大的偏差。
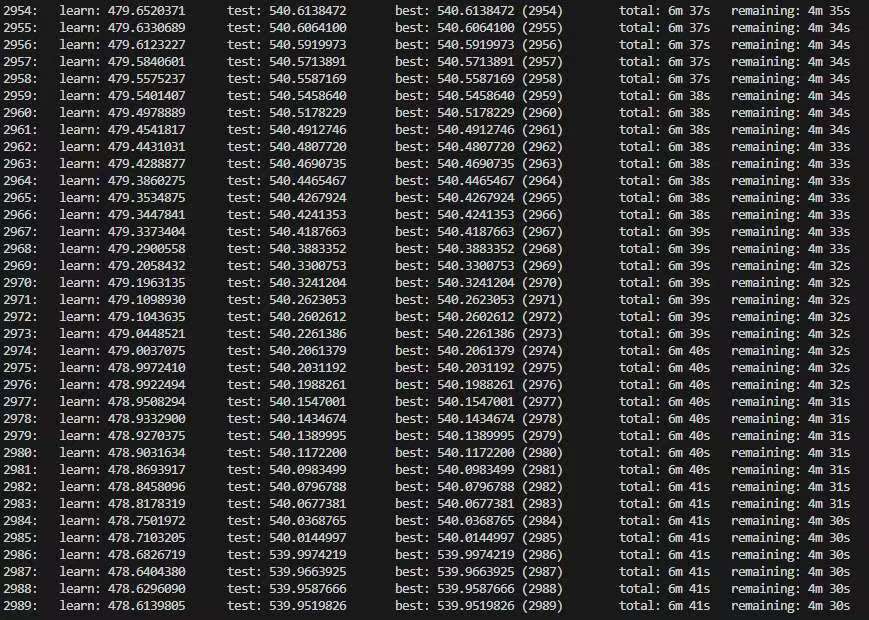
特征工程做完,就是让AI寻找模型的超级参数,这个过程时间比较久,我这个代码执行了近20个小时吧,记不太清,总之非常费时间。这个过程让AI写代码输出进度信息,不然命令行一直不懂,也不知道进度情况。
模型对比,AI可以快速生成不同模型训练的比对效果。CatBoost、XGBoost、神卡网络,单模型、多模型融合,等等。我选择的是CatBoost。
最终突破了500这关,抵达499分!
简单总结我的感受
MAE得分重点是特征工程,训练模型的超参数可以让AI生成超参数探索代码,花20个小时,就能拿到最优的参数。
特征工程程度与MAE得分
做了异常值处理、极端值处理、特征交互、log1处理 ,MAE能拿567分上下
做了统计特征,从训练集统计,合并到验证集、测试集,MAE能拿到516分上下
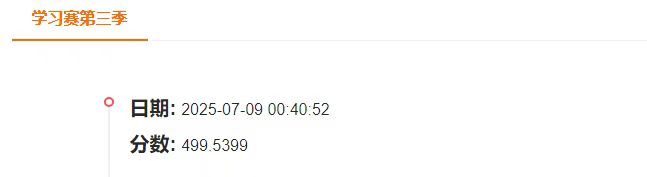
CatBoost超参数探索后,本地最优MAE 506分,竞赛评估结果499分
跑一次超参数20个小时,这是一个非常费时间的过程,跑一次就把参数记录下来,后面避免重复这个漫长的过程。
499再要向下突破,就得再想法子了。我的想法是,模型参数没有优化空间,就只能在特征工程上下功夫了。
499不是终点,后续再分享。
AI写代码工具 CodeBuddy