分类: Uncategorized

  • JVM性能调优(转)

    摘要

    了解JVM内存分配,垃圾回收机制和简单实战过程

    推荐GameKing的JVM学习笔记系列 和 cprime,更加细致

    0.JVM体系结构简介

    JVM Specification中的JVM整体架构

      主要包括两个子系统和两个组件,Class Loader(类装载)子系统,Execution Engine(执行引擎)子系统,Runtime Data Area(运行时数据区)组件,Native Interface(本地接口)组件。

      Class loader 子系统的作用 :根 据给定的全限定名类名(如 java.lang.Object)来装载class文件的内容到 Runtime data area 中的method area(方法区域)。Java 程序员可以extends java.lang.ClassLoader 类来写自己的Class loader。

      Execution engine 子系统的作用 :执 行 classes中的指令。任何 JVM specification实现(JDK)的核心是Execution engine, 换句话说:Sun 的JDK 和IBM的JDK好坏主要取决于他们各自实现的Execution  engine的好坏。每个运行中的线程都有一个 Execution engine的实例。 

      Native interface 组件 :与native libraries 交互,是其它编程语言交互的接口。 

      Runtime data area 组件:这个组件就是 JVM中的内存。

    Runtime data area 的整体架构图

      Runtime data area 主要包括五个部分:Heap (堆), Method Area(方法区域), Java Stack(java 的栈), Program Counter(程序计数器), Native method stack(本地方法栈)。Heap 和Method Area 是被所有线程的共享使用的;而Java stack, Program counter 和 Native method stack 是以线程为粒度的,每个线程独自拥有。

    Heap

       Java程序在运行时创建的所有类实例或数组都放在同一个堆中。而一个Java虚拟实例中只存在一个堆空间,因此所有线程都将共享这个堆。每一个 java程序独占一个JVM实例,因而每个 java程序都有它自己的堆空间,它们不会彼此干扰。但是同一java程序的多个线程都共享着同一个堆空间,就得考虑多线程访问对象(堆数据)的同步问 题。(这里可能出现的异常 java.lang.OutOfMemoryError: Java heap space) 

    Method area

       在Java 虚拟机中,被装载的 class的信息存储在 Method area的内存中。当虚拟机装载某个类型时,它使用类装载器定位相应的 class文件,然后读入这个class文件内容并把它传输到虚拟机中。紧接着虚拟机提取其中的类型信息,并将这些信息存储到方法区。该类型中的类(静 态)变量同样也存储在方法区中。与Heap 一样,method area 是多线程共享的,因此要考虑多线程访问的同步问题。比如,假设同时两个线程都企图访问一个名为 Lava的类,而这个类还没有内装载入虚拟机,那么,这时应该只有一个线程去装载它,而另一个线程则只能等待。 (这里可能出现的异常 java.lang.OutOfMemoryError: PermGen full)

    Java stack

       Java stack 以帧为单位保存线程的运行状态。虚拟机只会直接对 Java stack执行两种操作:以帧为单位的压栈或出栈。每当线程调用一个方法的时候,就对当前状态作为一个帧保存到 java stack 中(压栈);当一个方法调用返回时,从java stack 弹出一个帧(出栈)。栈的大小是有一定的限制,这个可能出现StackOverFlow 问题,例如递归的层数太深。

    Program counter 

      每个运行中的Java程序,每一个线程都有它自己的PC寄存器,也是该线程启动时创建的。PC寄存器的内容总是指向下一条将被执行指令的地址,这里的地址可以是一个本地指针,也可以是在方法区中相对应于该方法起始指令的偏移量。  

    Native method stack 

       对于一个运行中的Java程序而言,它还能会用到一些跟本地方法相关的数据区。当某个线程调用一个本地方法时,它就进入了一个全新的并且不再受虚拟机限 制的世界。本地方法可以通过本地方法接口来访问虚拟机的运行时数据区,不止如此,它还可以做任何它想做的事情。比如,可以调用寄存器,或在操作系统中分配 内存等。总之,本地方法具有和JVM 相同的能力和权限。  (这里出现 JVM无法控制的内存溢出问题 native heap OutOfMemory ) 。

    Sun JVM 中对 JVM Specification 的实现(内存部分)  

       JVM Specification只是抽象的说明了 JVM 实例按照子系统、内存区、数据类型以及指令这几个术语来描述的,  但是规范并非是要强制规定 Java 虚拟机实现内部的体系结构,更多的是为了严格地定义这些实现的外部特征。  Sun JVM 实现中:Runtime data area(JVM  内存)  五个部分中的 Java Stack , Program Counter, Native method stack 三部分和规范中的描述基本一致;但对 Heap  和  Method Area 进行了自己独特的实现。这个实现和 Sun JVM  的Garbage collector(垃圾回收)机制有关。  

    垃圾分代回收算法(Generational Collecting) 

      基于对对象生命周期分析后得出的垃圾回收算法。把对象分为年青代、年老代、持久代,对不同生命周期的对象使用不同的算法(上述方式中的一个)进行回收。现在的垃圾回收器(从J2SE1.2开始)都是使用此算法的。 

    如上图所示,为Java 堆中的各代分布。  

       1. Young(年轻代)JVM specification 中的  Heap的一部分。年轻代分三个区。一个Eden区,两个 Survivor区。大部分对象在Eden区中生成。当Eden区满时,还存活的对象将被复制到 Survivor区(两个中的一个),当这个 Survivor区满时,此区的存活对象将被复制到另外一个 Survivor区,当这个 Survivor去也满了的时候,从第一个Survivor区复制过来的并且此时还存活的对象,将被复制到年老区(Tenured)。需要注 意,Survivor的两个区是对称的,没先后关系,所以同一个区中可能同时存在从Eden复制过来的对象,和从前一个 Survivor复制过来的对象,而复制到年老区的只有从第一个 Survivor 去过来的对象。而且,Survivor 区总有一个是空的。  

      2. Tenured(年老代)JVM specification中的  Heap的一部分。年老代存放从年轻代存活的对象。一般来说年老代存放的都是生命期较长的对象。

       3. Perm(持久代)  JVM specification 中的  Method area 用于存放静态文件,如 Java 类、方法等。持久代对垃圾回收没有显著影响,但是有些应用可能动态生成或者调用一些 class,例如 Hibernate 等,在这种时候需要设置一个比较大的持久代空间来存放这些运行过程中新增的类。持久代大小通过-XX:MaxPermSize=进行设置。

    1.内存分代

    JVM的内存分代管理结构:

    JVM Tunning Practice(1) - 内存分代 - Harry - 染出一道彩虹

    下面是一些需要关注的常用的JVM内存配置参数,我们来看看它们是如何影响上图中的比例的。

    1)Heap Size

    -Xmx —最大Heap Size,即上图的Total size(包括Eden+form+to,Tenured,不包含Perm,见上图),限制了年轻代和年老代的可分配最大值;

    -Xms —初始化分配的Heap Size

    生产环境中ms一般设置成跟mx相等,因为若ms不等于mx那么在某些场景下JVM可能需要对Heap Size进行频繁的扩展和收缩,增加处理时间;

    2)New/Young Generation Size

    -Xmn —最大年轻代大小,即上图中的Eden+S0+S1+Virtual

    -XX:NewSize —初始化年轻代大小,即上图中的Eden+S0+S1,在只设置了-Xmn不设置-XX:NewSize的情况下,NewSize等于mn。

    生产环境中一般只需设置-Xmn或者设置mn和NewSize相等,理由和HeapSize的设置一样,避免容量震荡消耗资源;

    3)Old Generation Size (Tenured)

    -XX:NewRatio — Old Size/New Size,通过年老代和年轻代的比例和Heap Size就可以算出年老代的大小。一般默认为8,若Heap Size为1024m,则 NewSize=HeapSize/(NewRatio+1)=114m,OldSize=HeapSize-NewSize=910m;

    注意:-Xmn的优先级比-XX:NewRatio高,若-Xmn已指定,则OldSize=HeapSize-NewSize,无需再按比例计算。生产环境中一般只需指定-Xmn就足够了。

    4)Eden和S0、S1

    -XX:SurvivorRatio — Eden/S0,即 Eden区和S0的比例,默认为8,若NewSize为114m,则S0=NewSize/(SurvivorRatio+2)=11.4m;

    S0==S1,S0、S1的职能是一模一样的,又叫做From space和To space,在每一次minor gc后角色会交换。

    注意:-XX类型的选项在不同的JDK版本或实现中定义可能有所区别,在近日的实践中发现,

    在Linux jdk_1_5_0_10_x86版本中,SurvivorRatio=(YoungSize/S0),而Linux jdk_1_5_0_20_x64版本中,SurvivorRatio=(Eden/S0)

    所以,我们在实际的工程实践中还是应该用jmap -heap输出的jvm内存结构信息为准,不要想当然。

    5)Permanent Generation Size

    -XX:MaxPermSize —最大持久代大小,默认为64m;

    -XX:PermSize —初始化持久代大小,默认为16m;

    生产环境中一般设置MaxPermSize和PermSize相等,理由和HeapSize的设置一样,避免容量震荡消耗资源;

    当应用引用的类比较多或者应用了一些动态类生产技术时应该加大该区的值,一般256m对服务器程序都很足够了。

    下面是一些JVM对Native Memory内存的使用:

    6)Thread Stack Size

    -Xss —线程堆栈大小,一般用于存放方法入口参数和返回值,以及原子类型的本地变量(即方法内部变量);

    一般可设置为128k.

    7)Direct Memory Size

    -XX:MaxDirectMemorySize —direct byte buffer用到的本地内存,在本blog的一篇《xsocket内存泄漏》文章中介绍过该参数的作用。默认跟mx相等,所以生产环境中一般不设置mx大于物理内存的一半。

    2.GC过程 

    在讲述GC过程前我先解释一下JVM的两个控制参数:

    -XX:TargetSurvivorRatio — Survivor Space最大使用率,若存放对象的总大小超过该值,将引起对象向Old区迁移;

    -XX:MaxTenuringThreshold — Young区对象的最大任期阀值,即可经历minor gc的次数,超过该次数的对象直接迁移到Old区;

    实际的TenuringThreshold由JVM通过Survivor Space的占用率和TargetSurvivorRatio动态计算,详情请查看参考资料。

    《HP-MemoryManagement.pdf》中有对JVM GC过程的形象描述,我借用其中的一些图例来说明一下。

    1)Heap在初始状态

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    2)在Eden存放新对象

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    3)Eden空间不足分配新对象,进行第一次minor gc

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    4) Eden区再次被写满,进行第二次minor gc

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    5)Eden再次被写满,进行第3次minor gc

    第3次gc,发生了对象从from space提升到old区的迁移,然后也发生了from space到to space的copy

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    以下是Survivor space空间不足但对象的minor gc次数未到达MaxTenuringThreshold时的gc情况:

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC过程 - Harry - 染出一道彩虹

    3.GC实战 

    在进行GC Tuning时有两个很强大的利器:

    jstat:用于查看某java进程的gc情况;

    jmap:查看java进程堆栈分配和使用情况,以及dump出当前堆栈内容(可以用Eclipse MAT进行进一步分析)

    以上两个利器都是jdk自带,且无需java进程添加任何额外的debug信息输出参数的,直接就可以对任意java进程进行跟踪了。

           我认为GC调优的整体目标是要减缓GC的总体时间增加和降低每次gc引起的应用停顿(大概就是每次执行gc消耗的时间)。但往往我们只能在两者间获取一个平衡,在吞吐量和应用暂停时间之间取得一个平衡。

    JVM Tunning Practice(2) - GC Tunning - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC Tunning - Harry - 染出一道彩虹

    JVM Tunning Practice(2) - GC Tunning - Harry - 染出一道彩虹

    调优前配置:-Xmx1024m -Xms1024m

    调优前gc情况:jstat -gcutil <pid> 3000

    minor gc: 3~6次/3秒

    full gc: 1次/30秒

    调优后配置:-Xmx2g -Xms2g -Xmn1g -Xss128k -XX:NewSize=1g -XX:PermSize=128m

    -XX:MaxPermSize=256m -XX:SurvivorRatio=8 -XX:TargetSurvivorRatio=60 

    -XX:MaxTenuringThreshold=20 -XX:+UseParNewGC -XX:ParallelGCThreads=8 -XX:+UseConcMarkSweepGC -XX:CMSInitiatingOccupancyFraction=80 -XX:+CMSClassUnloadingEnabled -XX:+CMSPermGenSweepingEnabled -XX:+UseCMSCompactAtFullCollection -XX:CMSFullGCsBeforeCompaction=0

    调优后gc情况:

    minor gc: 1次/15秒

    full gc: 1次/数小时到数十小时

    UseParNewGC表示对新生代采用并行gc;

    ParallelGCThreads表示并行的线程数为8,一般是cpu的核个数,当核个数大于8时可能不是很适用;

    UseConcMarkSweepGC表示对full gc采用CMS gc;

    另外还有几个跟GC有关的有用参数,这里没有用到:

    -XX:+DisableExplicitGC 表示禁止显式gc,System.gc()

    -XX:+UseCMSCompactAtFullCollection 适用于CMS gc,表示在进行gc的同时清理内存碎片,但会加长gc的总时间

    -XX:CMSInitiatingOccupancyFraction=80 适用于CMS gc,表示在年老代达到80%使用率时马上进行回收

    另外下面是在JVM Crash时获heap信息的一些配置参数:

    -XX:ErrorFile=./xxx.log   JVM Crash时记录heap信息

    -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=./yyy.log JVM OOM时记录heap信息

    拿到heap文件后可以用Eclipse MAT进行分析,找出引起内存泄漏的class。

    参考资料:

    1)HP-MemoryManagement.pdf

    2)http://www.51testing.com/?uid-77492-action-viewspace-itemid-203728

    3)http://sunqi.javaeye.com/blog/486048

    4)http://fallenlord.blogbus.com/logs/57543373.html

    原文地址:http://harrywu304.blog.163.com/

  • C#泛型编程

    泛型:通过参数化类型来实现在同一份代码上操作多种数据类型。利用“参数化类型”将类型抽象化,从而实现灵活的复用。

    例子代码:

    class Program

    {

    static void Main(string[] args)

    {

    int obj = 2;

    Test<int> test = new Test<int>(obj);

    Console.WriteLine(“int:” + test.obj);

    string obj2 = “hello world”;

    Test<string> test1 = new Test<string>(obj2);

    Console.WriteLine(“String:” + test1.obj);

    Console.Read();

    }

    }

    class Test<T>

    {

    public T obj;

    public Test(T obj)

    {

    this.obj = obj;

    }

    }

    输出结果是:

    int:2

    String:hello world

    程序分析:

    1、 Test是一个泛型类。T是要实例化的范型类型。如果T被实例化为int型,那么成员变量obj就是int型的,如果T被实例化为string型,那么obj就是string类型的。

    2、 根据不同的类型,上面的程序显示出不同的值。

    C#泛型机制:

    C#泛型能力有CLR在运行时支持:C#泛型代码在编译为IL代码和元数据时,采用特殊的占位符来表示范型类型,并用专有的IL指令支持泛型操作。而真正的泛型实例化工作以“on-demand”的方式,发生在JIT编译时。

    看看刚才的代码中Main函数的元数据

    .method private hidebysig static void Main(string[] args) cil managed

    {

    .entrypoint

    // Code size 79 (0x4f)

    .maxstack 2

    .locals init ([0] int32 obj,

    [1] class CSharpStudy1.Test`1<int32> test,

    [2] string obj2,

    [3] class CSharpStudy1.Test`1<string> test1)

    IL_0000: nop

    IL_0001: ldc.i4.2

    IL_0002: stloc.0

    IL_0003: ldloc.0

    IL_0004: newobj instance void class CSharpStudy1.Test`1<int32>::.ctor(!0)

    IL_0009: stloc.1

    IL_000a: ldstr “int:”

    IL_000f: ldloc.1

    IL_0010: ldfld !0 class CSharpStudy1.Test`1<int32>::obj

    IL_0015: box [mscorlib]System.Int32

    IL_001a: call string [mscorlib]System.String::Concat(object,

    object)

    IL_001f: call void [mscorlib]System.Console::WriteLine(string)

    IL_0024: nop

    IL_0025: ldstr “hello world”

    IL_002a: stloc.2

    IL_002b: ldloc.2

    IL_002c: newobj instance void class CSharpStudy1.Test`1<string>::.ctor(!0)

    IL_0031: stloc.3

    IL_0032: ldstr “String:”

    IL_0037: ldloc.3

    IL_0038: ldfld !0 class CSharpStudy1.Test`1<string>::obj

    IL_003d: call string [mscorlib]System.String::Concat(string,

    string)

    IL_0042: call void [mscorlib]System.Console::WriteLine(string)

    IL_0047: nop

    IL_0048: call int32 [mscorlib]System.Console::Read()

    IL_004d: pop

    IL_004e: ret

    } // end of method Program::Main

    再来看看Test类中构造函数的元数据

    .method public hidebysig specialname rtspecialname

    instance void .ctor(!T obj) cil managed

    {

    // Code size 17 (0x11)

    .maxstack 8

    IL_0000: ldarg.0

    IL_0001: call instance void [mscorlib]System.Object::.ctor()

    IL_0006: nop

    IL_0007: nop

    IL_0008: ldarg.0

    IL_0009: ldarg.1

    IL_000a: stfld !0 class ConsoleCSharpTest1.Test`1<!T>::obj

    IL_000f: nop

    IL_0010: ret

    } // end of method Test`1::.ctor

    1、第一轮编译时,编译器只为Test<T>类型产生“泛型版”的IL代码与元数据——并不进行泛型的实例化,T在中间只充当占位符。例如:Test类型元数据中显示的<!T>

    2、JIT编译时,当JIT编译器第一次遇到Test<int>时,将用int替换“范型版”IL代码与元数据中的T——进行泛型类型的实例化。例如:Main函数中显示的<int>

    3、CLR为所有类型参数为“引用类型”的泛型类型产生同一份代码;但是如果类型参数为“值类型”,对每一个不同的“值类型”,CLR将为其产生一份独立的代码。因为实例化一个引用类型的泛型,它在内存中分配的大小是一样的,但是当实例化一个值类型的时候,在内存中分配的大小是不一样的。

    C#泛型特点:

    1、如果实例化泛型类型的参数相同,那么JIT编辑器会重复使用该类型,因此C#的动态泛型能力避免了C++静态模板可能导致的代码膨胀的问题。

    2、C#泛型类型携带有丰富的元数据,因此C#的泛型类型可以应用于强大的反射技术。

    3、C#的泛型采用“基类、接口、构造器,值类型/引用类型”的约束方式来实现对类型参数的“显示约束”,提高了类型安全的同时,也丧失了C++模板基于“签名”的隐式约束所具有的高灵活性

    C#泛型继承:

    C#除了可以单独声明泛型类型(包括类与结构)外,也可以在基类中包含泛型类型的声明。但基类如果是泛型类,它的类型要么以实例化,要么来源于子类(同样是泛型类型)声明的类型参数,看如下类型

    class C<U,V>

    class D:C<string,int>

    class E<U,V>:C<U,V>

    class F<U,V>:C<string,int>

    class G:C<U,V> //非法

    E类型为C类型提供了U、V,也就是上面说的来源于子类

    F类型继承于C<string,int>,个人认为可以看成F继承一个非泛型的类

    G类型为非法的,因为G类型不是泛型,C是泛型,G无法给C提供泛型的实例化

    泛型类型的成员:

    泛型类型的成员可以使用泛型类型声明中的类型参数。但类型参数如果没有任何约束,则只能在该类型上使用从System.Object继承的公有成员。如下图:

    泛型接口:

    泛型接口的类型参数要么已实例化,要么来源于实现类声明的类型参数

    泛型委托:

    泛型委托支持在委托返回值和参数上应用参数类型,这些参数类型同样可以附带合法的约束

    delegate bool MyDelegate<T>(T value);

    class MyClass

    {

    static bool F(int i){…}

    static bool G(string s){…}

    static void Main()

    {

    MyDelegate<string> p2 = G;

    MyDelegate<int> p1 = new MyDelegate<int>(F);

    }

    }

    泛型方法:

    1、C#泛型机制只支持“在方法声明上包含类型参数”——即泛型方法。

    2、C#泛型机制不支持在除方法外的其他成员(包括属性、事件、索引器、构造器、析构器)的声明上包含类型参数,但这些成员本身可以包含在泛型类型中,并使用泛型类型的类型参数。

    3、泛型方法既可以包含在泛型类型中,也可以包含在非泛型类型中。

    泛型方法声明:如下

    public static int FunctionName<T>(T value){…}

    泛型方法的重载:

    public void Function1<T>(T a);

    public void Function1<U>(U a);

    这样是不能构成泛型方法的重载。因为编译器无法确定泛型类型T和U是否不同,也就无法确定这两个方法是否不同

    public void Function1<T>(int x);

    public void Function1(int x);

    这样可以构成重载

    public void Function1<T>(T t) where T:A;

    public void Function1<T>(T t) where T:B;

    这样不能构成泛型方法的重载。因为编译器无法确定约束条件中的A和B是否不同,也就无法确定这两个方法是否不同

    泛型方法重写:

    在重写的过程中,抽象类中的抽象方法的约束是被默认继承的。如下:

    abstract class Base

    {

    public abstract T F<T,U>(T t,U u) where U:T;

    public abstract T G<T>(T t) where T:IComparable;

    }

    class MyClass:Base

    {

    public override X F<X,Y>(X x,Y y){…}

    public override T G<T>(T t) where T:IComparable{}

    }

    对于MyClass中两个重写的方法来说

    F方法是合法的,约束被默认继承

    G方法是非法的,指定任何约束都是多余的

    泛型约束:

    1、C#泛型要求对“所有泛型类型或泛型方法的类型参数”的任何假定,都要基于“显式的约束”,以维护C#所要求的类型安全。

    2、“显式约束”由where子句表达,可以指定“基类约束”,“接口约束”,“构造器约束”,“值类型/引用类型约束”共四种约束。

    3、“显式约束”并非必须,如果没有指定“显式约束”,范型类型参数将只能访问System.Object类型中的公有方法。例如:在开始的例子中,定义的那个obj成员变量。比如我们在开始的那个例子中加入一个Test1类,在它当中定义两个公共方法Func1、Func2,如下图:

    下面就开始分析这些约束:

    基类约束:

    class A

    {

    public void Func1()

    { }

    }

    class B

    {

    public void Func2()

    { }

    }

    class C<S, T>

    where S : A

    where T : B

    {

    public C(S s,T t)

    {

    //S的变量可以调用Func1方法

    s.Func1();

    //T的变量可以调用Func2方法

    t.Func2();

    }

    }

    接口约束:

    interface IA<T>

    {

    T Func1();

    }

    interface IB

    {

    void Func2();

    }

    interface IC<T>

    {

    T Func3();

    }

    class MyClass<T, V>

    where T : IA<T>

    where V : IB, IC<V>

    {

    public MyClass(T t,V v)

    {

    //T的对象可以调用Func1

    t.Func1();

    //V的对象可以调用Func2和Func3

    v.Func2();

    v.Func3();

    }

    }

    构造器约束:

    class A

    {

    public A()

    { }

    }

    class B

    {

    public B(int i)

    { }

    }

    class C<T> where T : new()

    {

    T t;

    public C()

    {

    t = new T();

    }

    }

    class D

    {

    public void Func()

    {

    C<A> c = new C<A>();

    C<B> d = new C<B>();

    }

    }

    d对象在编译时报错:The type B must have a public parameterless constructor in order to use it as parameter ‘T’ in the generic type or method C<T>

    注意:C#现在只支持无参的构造器约束

    此时由于我们为B类型写入了一个有参构造器,使得系统不会再为B自动创建一个无参的构造器,但是如果我们将B类型中加一个无参构造器,那么对象d的实例化就不会报错了。B类型定义如下:

    class B

    {

    public B()

    { }

    public B(int i)

    { }

    }

    值类型/引用类型:

    public struct A { }

    public class B { }

    public class C<T> where T : struct

    {

    }

    C<A> c1 = new C<A>();

    C<B> c2 = new C<B>();

    c2对象在编译时报错:The type ‘B’ must be a non-nullable value type in order to use it as parameter ‘T’ in the generic type or methor ‘C<T>’

    总结:

    1、C#的泛型能力由CLR在运行时支持,它既不同于C++在编译时所支持的静态模板,也不同于Java在编译器层面使用“擦拭法”支持的简单的泛型。

    2、C#的泛型支持包括类、结构、接口、委托四种泛型类型,以及方法成员。

    3、C#的泛型采用“基类,接口,构造器,值类型/引用类型”的约束方式来实现对类型参数的“显式约束”,它不支持C++模板那样的基于签名的隐式约束。

    转自:http://www.cnblogs.com/kid-li/archive/2006/11/29/577045.html

  • “找你妹”在工作中的应用:Null值无法转化为数值

    Bug提示得非常迷惑,不好直接定位问题。
    第一步:定位到出错的代码段,查看报错信息。找不出具体问题,出现代码是将一个JSON串序列化成一个对象,字段较多,使用Chrome反序列化之后的结果一看,好多字段是null,到底是哪个字段引发的bug。如果Mock此段代码,逐一去检测,好像是一种处理方式。But…还得倒腾工程,于是暂时搁置此思路。
    第二步:整体上分析此段代码,这段代码的整体特征是,由代码生成工具生成。莫非被人工改动过?为了验证此猜想,立即生成了一遍,Compare的结果是,虽然人工调整过代码,但是与bug不相干,代码的调整仅限于页面显示文字的调整。
    第三步 “找你妹”,找了一个正常的具备类比性的模块代码配置,截个图,比着看了一下,结果发现,Client_id配置不一致。找开数据库查看字段类型,数据库不允许为空,实际业务上来,这个地方是为空的。
    第四步 调整Client_ID字段类型,允许为空,配置代码生成规则,允许Client_ID为空,K.O.
    第五步 以生产环境备份做基线测试…
    K.O.

  • Configure an Application Pool to Recycle at a Scheduled Time (IIS 7)

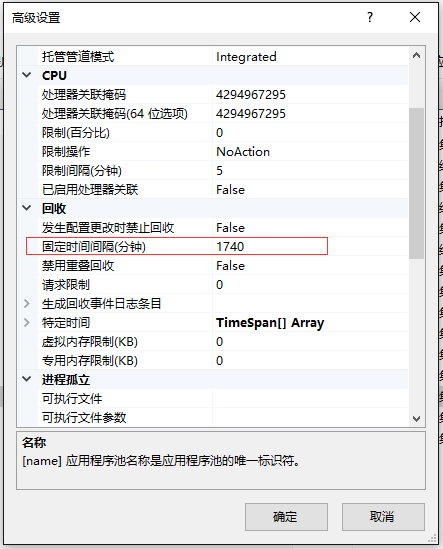
    IIS默认的应用程序池回收时间是29小时,这个时间,有点“神秘”,不排除在业务繁忙期间。因此指定在凌晨会更靠谱些。有的小伙伴写VB脚本,再计划任务,感觉不如直接使用appcmd命令直接解决指定时间回收的需求。

    image

    For example, to schedule an application pool named Marketing to recycle daily at 3:00 PM, type the following at the command prompt, and then press ENTER:

    appcmd set apppool /apppool.name: Marketing /+recycling.periodicRestart.schedule.[value=’15:00:00′]

    For example, if you want the Marketing application pool from the previous example to recycle at 5:00 PM, type the following at the command prompt and then press ENTER:

    appcmd set apppool /apppool.name: Marketing /recycling.periodicRestart.schedule.[value=’15:00:00′].value:17:00:00

    源自:https://technet.microsoft.com/en-us/library/6c74bc0a-cf98-4ac3-93c2-3991c09502fe

  • IIS站点不间断更新服务(热部署)IDEA

    最近做应用发布的工作比较多,考虑到白天会有第三方平台(跨境购)推送订单过来,一般白天也不做部署更新。如果白天要做部署,应该如何做呢?

    方案一:本身工程结构不做调整,增加一个第三方平台接口路由中转。

    由于第三方平台接口相对是稳定的,意味着接口路由器也是稳定的,接口路由器,有点像Channel Interface(Not every body known this),本身仅请第三方请求做中转,并将请求持久化下来。在做更新的时候,万一有订单、商品等请求过来,可以使用接口路由器重发报文。这样子,应用站点就可以任性的随时更新了,不用等到一个特定时间去部署更新。而且,怎么选时间去部署,都有丢报文的风险。

    方案二:调整工程,抽离引擎代码、业务代码,大DLL分解成小Dll,拆分,拆分

    这种做法与接口路由是有神似的地方,找出变化点,抽离出来。目前来看,工程build之后一个大大的api dll,内部系统、brother系统、第三方系统接口全在一起,内部做个小调整,部署还要影响第三方系统接口的正常访问。这个是一个问题点。另外,针对第三方平台的工程组成,至少分离出报文接收+报文处理,报文接收的调整可能性非常小,实时更新报文处理组件的时候,如造成异常,还能找到报文。

    调整自然有好有坏,这么拆拆拆,会拆出一堆小工程出来。一堆小组件,一堆小引擎。

    方案三:部署自动化,Package可以不断的发布到一个缓冲池里,凌晨的时候自动释放。

    这种方式,要求精心制作Package,能用自动验证Package是否正常发布,毕竟是自动完成。这种方式有点穿越,站在了不同的时间轴上。对于研发来说,发布,上传了Package,应用程序并不实时更新,但是可以当成“完成了”发布。这种方案同样需要研发一套Package标准+更新引擎。

    方案四:大名为“云部署”、“云应用”

    将Package部署包制作完之后,放到一个应用市场中,研发人员不管更新了,由业务人员依据业务情况更新。这种方案同样需要研发一套Package标准+更新引擎。这种方案,在软件客户超过1个,比较省心。如果达到几十上百,那应该是不错的部署更新方案了。

  • Select Update形成的死锁ABC

    事务(进程 ID 60)与另一个进程被死锁在 锁 资源上,并且已被选作死锁牺牲品。请重新运行该事务。

    查资料的大意,select使用了非聚集索引,会形成一个S锁,而update修改的列是非聚集索引的列,于是针对这个非聚集索引增加了一个X锁,然后就死锁了。

    我也被绕晕了,请自行查看原博主的文章详细了解。对于什么是聚集索引,什么是非聚集索引,偶也转载了一篇通俗易懂的文章 。就是上一篇啦!

    由于博主明确注意要经过允许后才转载,Balabala,来2个链接好了。

    参考解决方案 :

    http://blog.csdn.net/lishehe/article/details/42279147

    http://blog.csdn.net/lishehe/article/details/42303457